BAGEL 少步蒸馏 · 方法对比
kokoro_ode/build_report.py 生成,每次评测后重跑 · 网格是 800 px 缩略图,放大页是原图(PNG,原分辨率);点图进查看器:←/→ 换蒸馏算法,T 教师,R 未训练 4 步,G GT,↑/↓ 换 prompt,[ ] 换训练步,W EMA/student,S 换种子,点图 1:1,Esc 关闭 · 图片在同目录 raw/,要连 results/ 整个目录打开受控条件
- 教师:同一个 3750(CFG 蒸馏版)。B / D / A / C 的学生与 fake 都从 3750 起步;ODE-init → TDM / PDD 的学生从 ODE-init 500 的 student 起步,fake 仍从 3750 复制(PDD 不用 fake)。
- 数据:同一份配置
kokoro_ode/data_mainline_1024.yaml(主线 1024 档,t2i : i2i = 10 : 13),batch 32;各组读同一数据集、同分布(10-06 起任务抽样改用独立随机源,同起点续训的各组样本顺序也一致)。 - 学生推理 4 步:B / D 用旧 Wan 表 0.999 / 0.937 / 0.833 / 0.624 / 0(shift 5);10-07 起新开的组(ODE-init、TDM、PDD、A、C)用 shift 3 表 0.999 / 0.9 / 0.75 / 0.5 / 0(与 BAGEL 推理同一个 shift),和 B / D 比时混有换表的影响;放大页 R 对照同一张表的未训练学生。训练进程里这些 t 量化到 bf16(1 / 0.9375 / 0.832 / 0.625;1 / 0.898 / 0.75 / 0.5),评测脚本按 fp32 建网络(bf16 autocast)、t 不量化,两边数值不逐位相同(同种子同构图,抽查 PSNR 约 30 dB)。
- 评测在 heldout15 × 种子 42 / 100 / 1024 上出图:主线 bagel_mr_1002 的留出集,DMD 训练数据用 blocklist 排除了它们(其中 11 条在更早的训练数据包里出现过,教师 3750 训练时是否见过未核实);分辨率 = 各条 GT 尺寸(1024 档);教师 41 步用同样的 prompt / 种子。
- 计划各组统一训到 1000 iter:B / D 10-06 训过了 1000(B 到 1250、D 到 1125 才停),取 1000 存档;ODE-init 前置段 500;PDD(lr 1e-5)与 C 中途停(见方法表)。按训练步对齐比较(iter 相同);各方法的学生更新比不同,表里另列学生更新次数。方法自身的 lr / τ 分布按各自参考实现取值。
- 配方 2(run 名带 _r2,10-11 起):VSD 加噪 τ 一律 shift 3(学生与 fake 同分布;之前 A / B / C 是 5)、Adam β2 0.95、学习率余弦到 0、教师 cfg 嵌入 text 4 / img 1.5(之前 4 / 2),与 CFG 蒸馏对齐;和配方 1 的旧 run 不是单变量对比,配方 2 的各组之间互相比。
方法
| 方法 | 做法 | 训练状态 | 已评测的训练步 |
|---|---|---|---|
| B · DMD2 + ODE 展开 | 学生从纯噪声按 4 步表 ODE 展开到随机出口步,再带梯度走一步;VSD(x0 归一化,τ shift 5);fake:学生 = 4:1(4 步表:旧 Wan 表(shift 5)) | 已完成 1000 | 500, 750, 1000 |
| D · DP-DMD | 走完 4 步(第 1 步后 detach),第 1 步对齐教师锚点(30 步 shift 3 网格的第 5 点 t=0.9375,= 学生第 1 步落点)+ VSD(x_t 归一化,τ shift 3);fake:学生 = 5:1(4 步表:旧 Wan 表(shift 5)) | 已完成 1000 | 500, 750, 1000 |
| A · 上一轮配方 | 学生输入 = 真实图加噪(SDE 分布),推理走 ODE —— 基线(4 步表:shift 3 表) | 已完成 1000 | 250, 500, 750, 1000 |
| C · B + DMDO | B 的基础上:VSD 加噪用这条轨迹自己的起点噪声 x_T(Hyper-Bagel DMDO);fake 改用完整 4 步终图与 x_T 插值(4 步表:shift 3 表) | 已停 用户看训练内预览判定效果不好,10-07 19:50 在 ~475 步停、让出 4–7 号卡;只有 250 存档(未出图),过程看下方训练内预览 | — |
| A · 配方 2 | 同 A;配方 2:VSD τ shift 3(学生与 fake 同分布)、Adam β2 0.95、学习率余弦到 0、教师 cfg_img 1.5(与 CFG 蒸馏对齐)(4 步表:shift 3 表) | 已完成 1000 | 250, 500, 750, 1000 |
| B · 配方 2 | 同 B,学生 4 步表换 shift 3 表;配方 2:VSD τ shift 3、Adam β2 0.95、学习率余弦到 0、教师 cfg_img 1.5(4 步表:shift 3 表) | 已完成 1000 | 250, 500, 750, 1000 |
| D · 配方 2 | 同 D,学生 4 步表换 shift 3 表(DP-DMD 锚点 40 步网格第 10 点 t=0.9);配方 2:β2 0.95、学习率余弦到 0、教师 cfg_img 1.5(VSD τ 本来就是 shift 3)(4 步表:shift 3 表) | 已完成 1000 | 250, 500, 750, 1000 |
| ODE-init → TDM · fake 权重下限 f = 0.25 | 同 ODE-init → TDM(配方 1,同一个 ODE-init 500 起点),只把 fake 的 v-MSE 权重改成 min(1, 5/SNR)·max((1−τ)², 0.25):τ ≤ 0.5 与 demo 等价、更高噪声停在 0.25(方法文档 §3.3)(4 步表:shift 3 表) | 已完成 1000 | 250, 500, 750, 1000 |
| ODE-init(前置阶段本身) | 在线跑教师 ODE 轨迹(40 步网格 shift 3 并入学生 4 个时间点,cfg 4 / 2),学生在这 4 点回归教师终点;8 卡 500 iter,产物同时喂 TDM 和 PDD(4 步表:shift 3 表) | 已完成 500 | 250, 500 |
| ODE-init → TDM | 先回归教师 ODE 轨迹(ODE-init),再接 TDM(本步落点、本步噪声区间内比较)(4 步表:shift 3 表) | 已完成 1000 | 250, 500, 750, 1000 |
| ODE-init → PDD(lr 1e-5) | 先 ODE-init,再接平行解码蒸馏(细网格平均速度,无 fake score);学生 lr 1e-5(论文值,但论文 batch 2048)(4 步表:shift 3 表) | 已停 4 步预览第 120 步正常、150 步发脏、180 步起崩成涂鸦,没再恢复;10-07 15:40 在 575 步停,存档 250 / 500 出图留档(权重只留 500) | 250, 500 |
| ODE-init → PDD(lr 4e-6) | 同上,学生 lr 降到 4e-6(= TDM 的学生 lr)重跑;原排在 C 之后(4 步表:shift 3 表) | 暂缓 C 停后用户定暂时不跑(10-07 20:00),没有排队 | — |
指标(heldout15 × 种子 42 / 100 / 1024)
| 模型 | 训练步 | 学生更新次数 | 权重 | 锐度 / 教师 | 种子间差异 |
|---|---|---|---|---|---|
| 教师 41 步 | — | — | — | 1.00 | 0.208 |
| 教师 40 步 · cfg_img 1.5 | — | — | — | 0.96 | 0.207 |
| 未训练学生 4 步(旧表) | — | — | — | 0.20 | 0.107 |
| 未训练学生 4 步(shift 3 表) | — | — | — | 0.18 | 0.090 |
| A | 250 | 50 | ema | 1.30 | 0.173 |
| A | 250 | 50 | student | 1.39 | 0.176 |
| A | 250 | 50 | ema | 0.89 | 0.137 |
| A | 250 | 50 | student | 0.96 | 0.141 |
| B | 250 | 50 | ema | 1.00 | 0.176 |
| B | 250 | 50 | student | 1.07 | 0.181 |
| D | 250 | 41 | ema | 1.20 | 0.219 |
| D | 250 | 41 | student | 1.20 | 0.223 |
| ODE-init → TDM | 250 | 125 | ema | 1.32 | 0.265 |
| ODE-init → TDM | 250 | 125 | student | 1.36 | 0.267 |
| ODE-init(前置阶段本身) | 250 | 250 | ema | 0.79 | 0.230 |
| ODE-init(前置阶段本身) | 250 | 250 | student | 0.81 | 0.233 |
| ODE-init → TDM | 250 | 125 | ema | 1.36 | 0.268 |
| ODE-init → TDM | 250 | 125 | student | 1.40 | 0.270 |
| ODE-init → PDD(lr 1e-5) | 250 | 250 | ema | 0.06 | 0.471 |
| ODE-init → PDD(lr 1e-5) | 250 | 250 | student | 0.04 | 0.467 |
| B | 500 | 100 | ema | 1.15 | 0.214 |
| B | 500 | 100 | student | 1.29 | 0.219 |
| D | 500 | 83 | ema | 1.20 | 0.230 |
| D | 500 | 83 | student | 1.27 | 0.233 |
| A | 500 | 100 | ema | 1.94 | 0.214 |
| A | 500 | 100 | student | 2.03 | 0.224 |
| A | 500 | 100 | ema | 1.51 | 0.180 |
| A | 500 | 100 | student | 1.56 | 0.184 |
| B | 500 | 100 | ema | 1.16 | 0.209 |
| B | 500 | 100 | student | 1.21 | 0.213 |
| D | 500 | 83 | ema | 1.12 | 0.217 |
| D | 500 | 83 | student | 1.09 | 0.218 |
| ODE-init → TDM | 500 | 250 | ema | 1.48 | 0.259 |
| ODE-init → TDM | 500 | 250 | student | 1.49 | 0.259 |
| ODE-init(前置阶段本身) | 500 | 500 | ema | 1.01 | 0.245 |
| ODE-init(前置阶段本身) | 500 | 500 | student | 1.01 | 0.245 |
| ODE-init → TDM | 500 | 250 | ema | 1.48 | 0.262 |
| ODE-init → TDM | 500 | 250 | student | 1.51 | 0.265 |
| ODE-init → PDD(lr 1e-5) | 500 | 500 | ema | 0.18 | 0.481 |
| ODE-init → PDD(lr 1e-5) | 500 | 500 | student | 0.14 | 0.479 |
| B | 750 | 150 | ema | 1.38 | 0.239 |
| B | 750 | 150 | student | 1.36 | 0.240 |
| D | 750 | 125 | ema | 1.21 | 0.226 |
| D | 750 | 125 | student | 1.17 | 0.228 |
| A | 750 | 150 | ema | 2.26 | 0.241 |
| A | 750 | 150 | student | 2.22 | 0.242 |
| A | 750 | 150 | ema | 1.58 | 0.199 |
| A | 750 | 150 | student | 1.54 | 0.199 |
| B | 750 | 150 | ema | 1.41 | 0.228 |
| B | 750 | 150 | student | 1.41 | 0.229 |
| D | 750 | 125 | ema | 1.17 | 0.222 |
| D | 750 | 125 | student | 1.16 | 0.222 |
| ODE-init → TDM | 750 | 375 | ema | 1.58 | 0.261 |
| ODE-init → TDM | 750 | 375 | student | 1.61 | 0.261 |
| ODE-init → TDM | 750 | 375 | ema | 1.53 | 0.268 |
| ODE-init → TDM | 750 | 375 | student | 1.54 | 0.269 |
| B | 1000 | 200 | ema | 1.31 | 0.234 |
| B | 1000 | 200 | student | 1.31 | 0.233 |
| D | 1000 | 166 | ema | 1.25 | 0.218 |
| D | 1000 | 166 | student | 1.19 | 0.211 |
| A | 1000 | 200 | ema | 2.23 | 0.243 |
| A | 1000 | 200 | student | 2.37 | 0.241 |
| A | 1000 | 200 | ema | 1.58 | 0.201 |
| A | 1000 | 200 | student | 1.58 | 0.201 |
| B | 1000 | 200 | ema | 1.45 | 0.229 |
| B | 1000 | 200 | student | 1.45 | 0.229 |
| D | 1000 | 166 | ema | 1.19 | 0.222 |
| D | 1000 | 166 | student | 1.19 | 0.222 |
| ODE-init → TDM | 1000 | 500 | ema | 1.65 | 0.262 |
| ODE-init → TDM | 1000 | 500 | student | 1.64 | 0.264 |
| ODE-init → TDM | 1000 | 500 | ema | 1.56 | 0.265 |
| ODE-init → TDM | 1000 | 500 | student | 1.51 | 0.262 |
训练内预览(训练进程自己出的 4 步图)
B · DMD2 + ODE 展开 arm_B_1006 · 22 张,iter 100–1230


D · DP-DMD arm_D_1006 · 14 张,iter 300–1110


A · 上一轮配方 arm_A_s3_1007 · 33 张,iter 30–990


C · B + DMDO arm_C_s3_1007 · 15 张,iter 30–450


A · 配方 2 arm_A_r2_1011 · 33 张,iter 30–990


B · 配方 2 arm_B_r2_1011 · 33 张,iter 30–990


ODE-init(前置阶段本身) odeinit_s3_1007 · 17 张,iter 1–480


ODE-init → TDM odeinit_TDM_s3_1007 · 33 张,iter 30–990


ODE-init → PDD(lr 1e-5) odeinit_PDD_s3_1007 · 20 张,iter 1–570


诊断记录(拿来下结论的图与数)
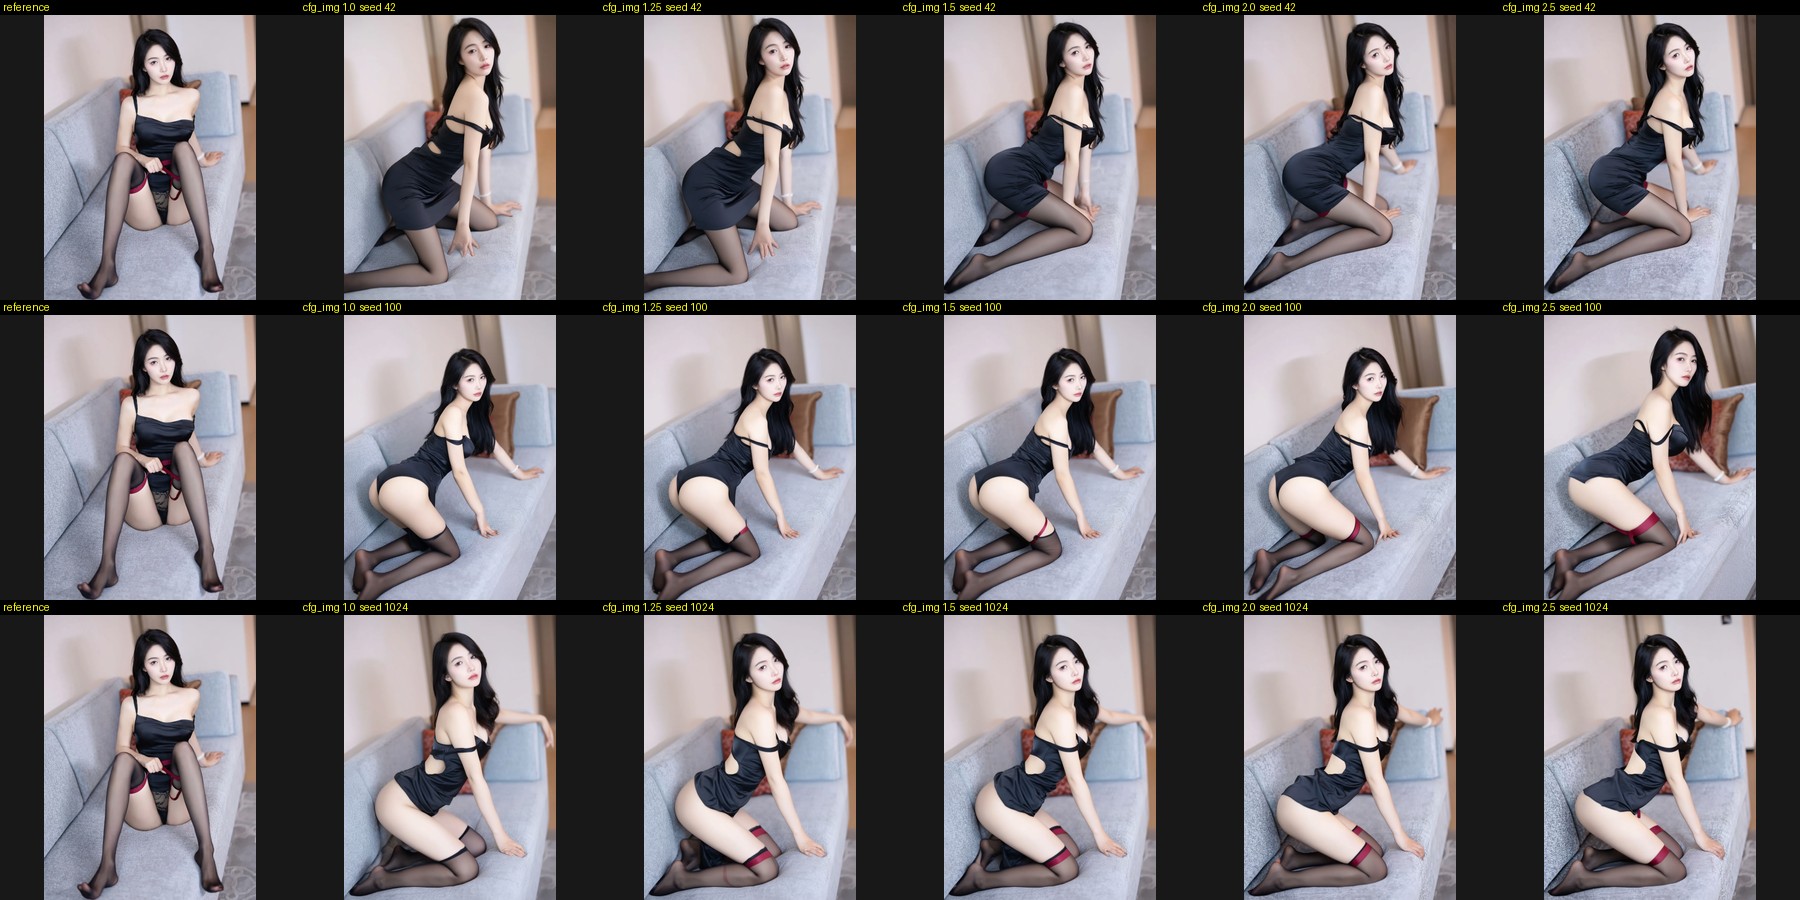
主线 exports/0028000 EMA 的 img cfg 响应(i2i,cfg_text 4,10-08) 2026-10-08 08:50 SGT · raw/diag_cfgimg_1008/
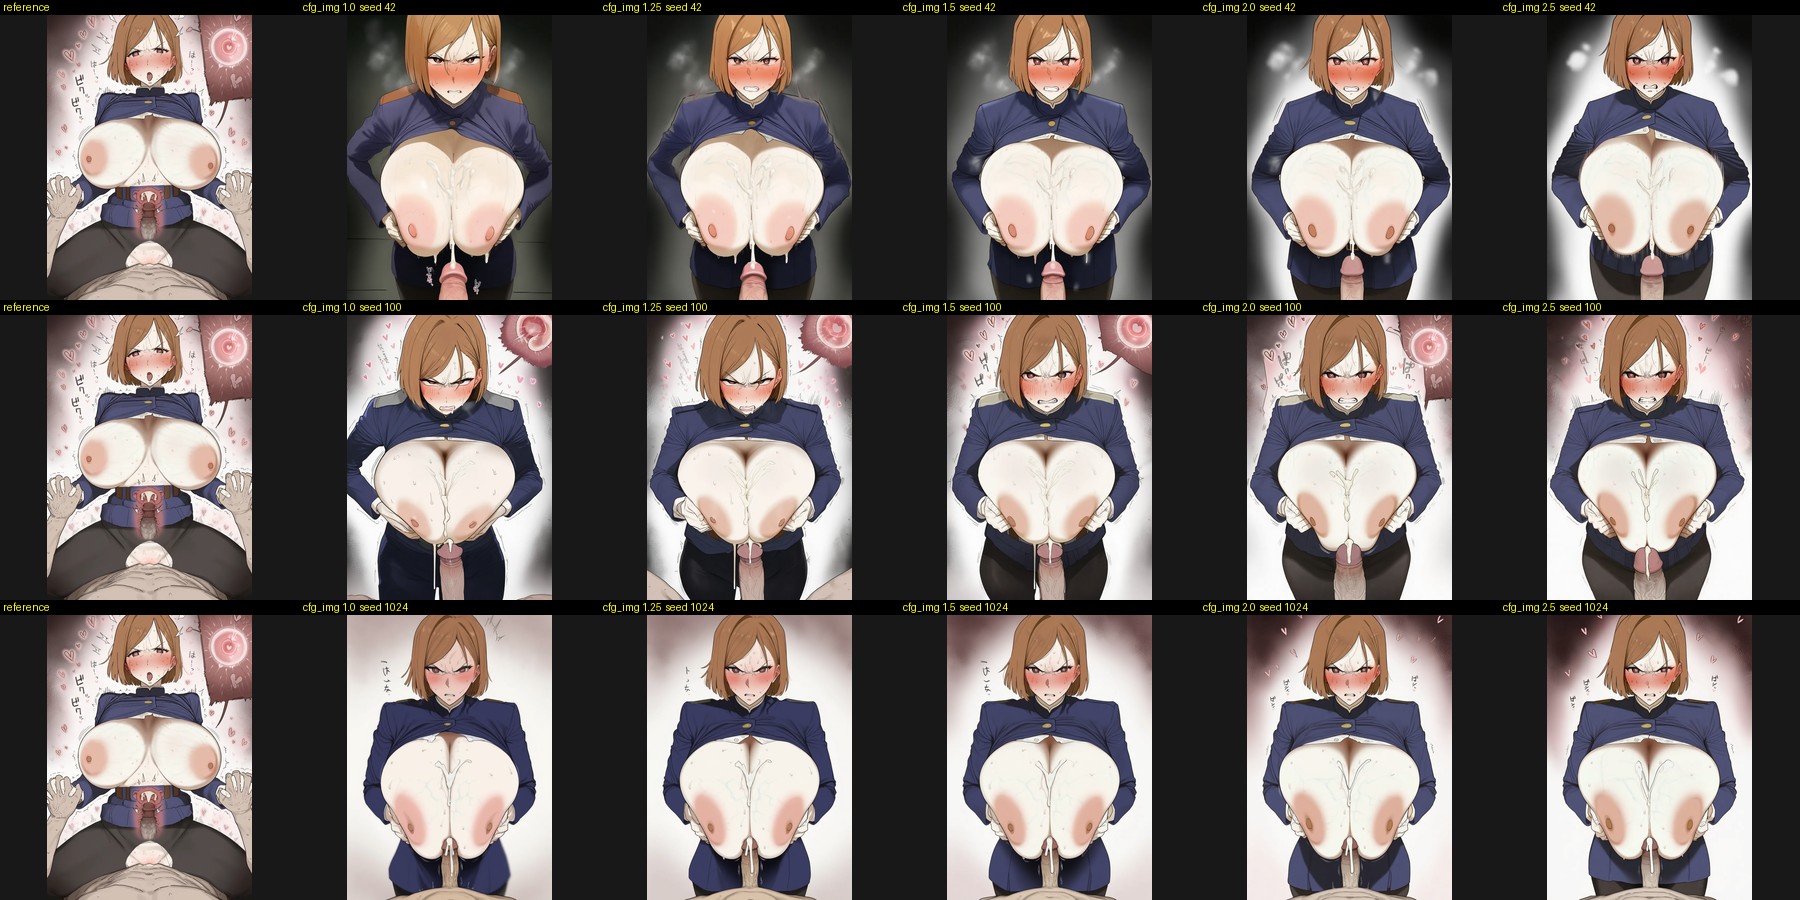
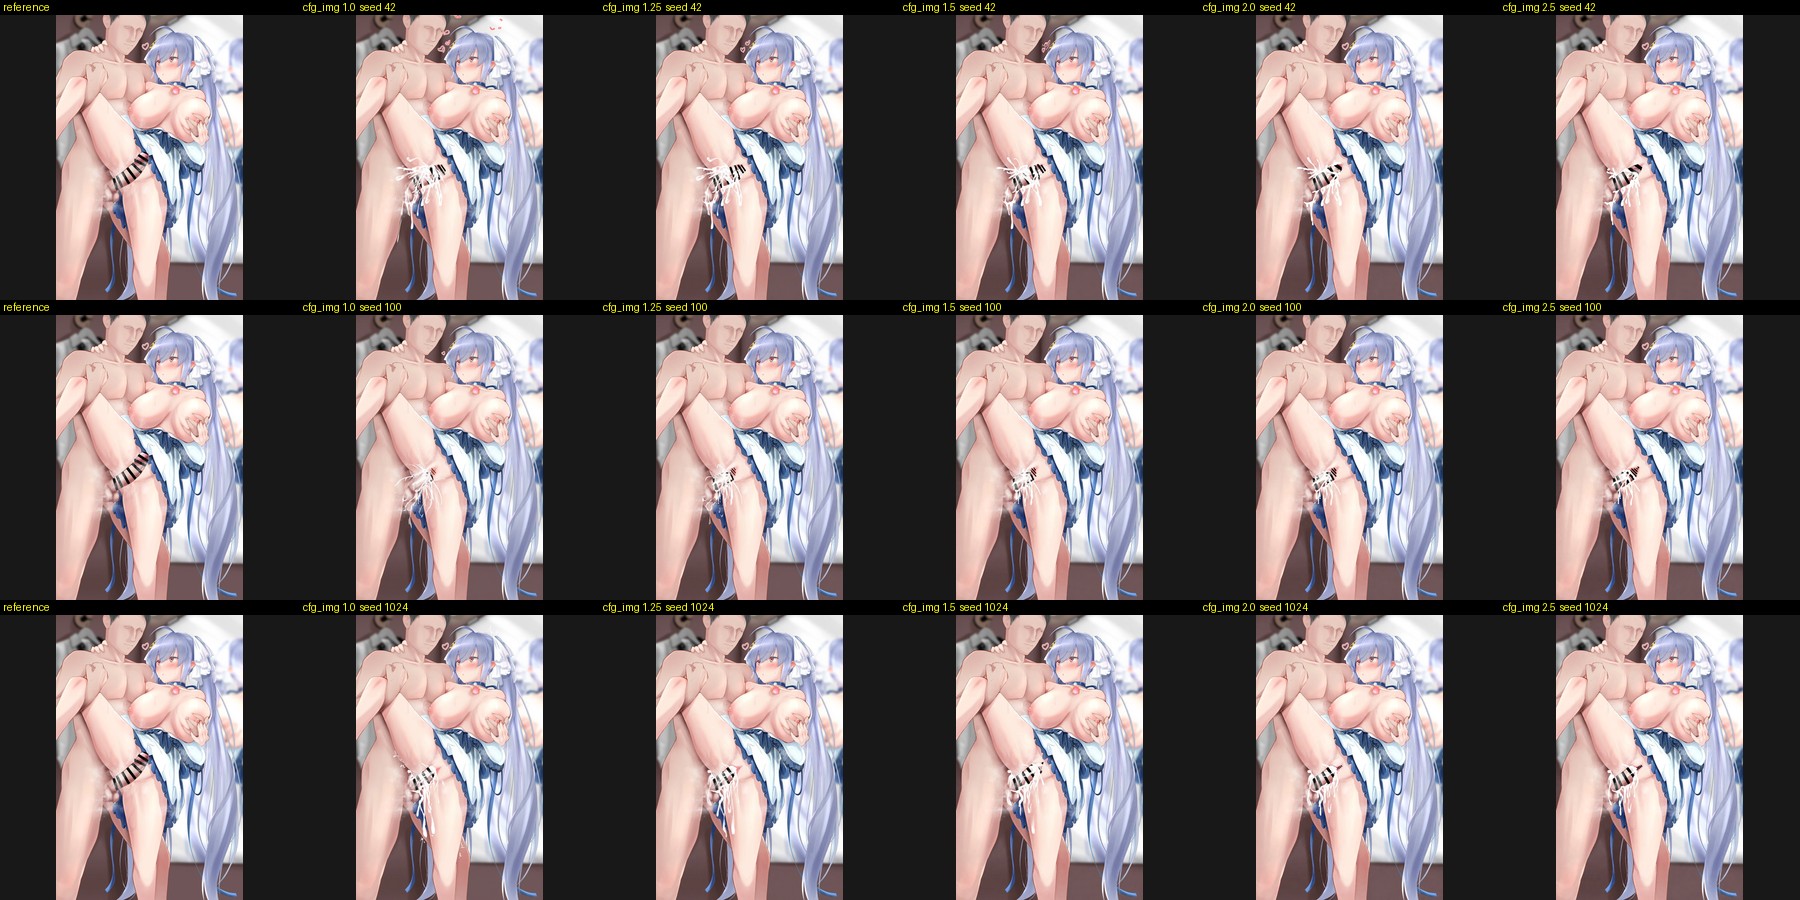
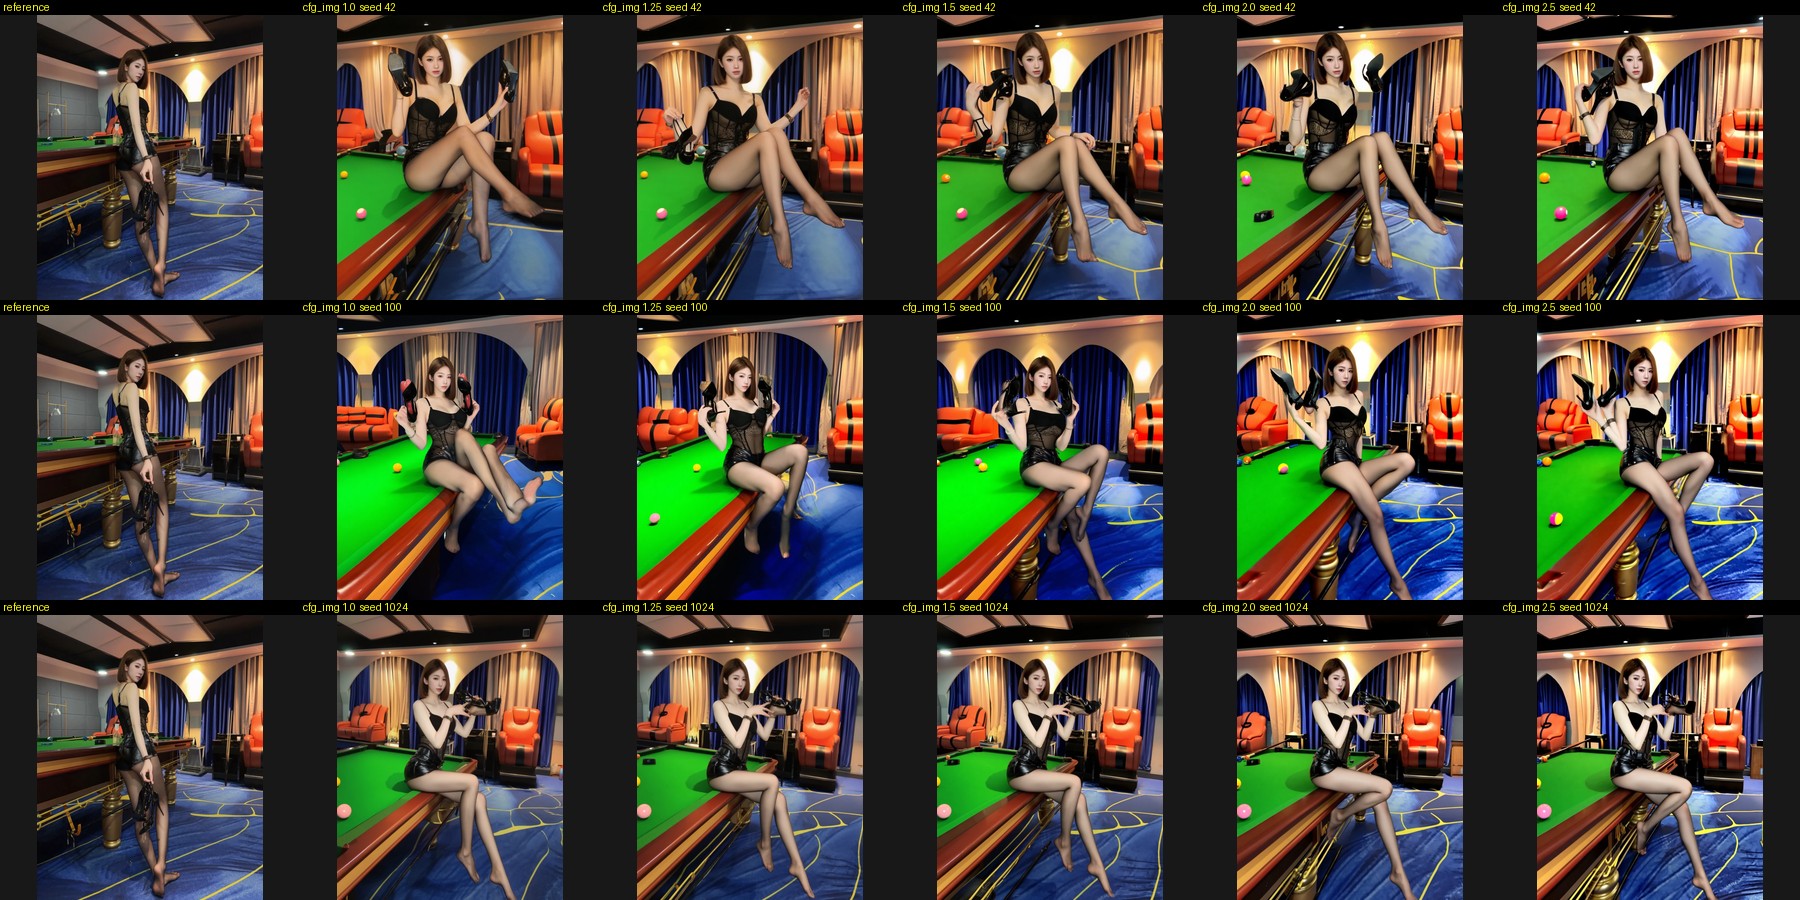
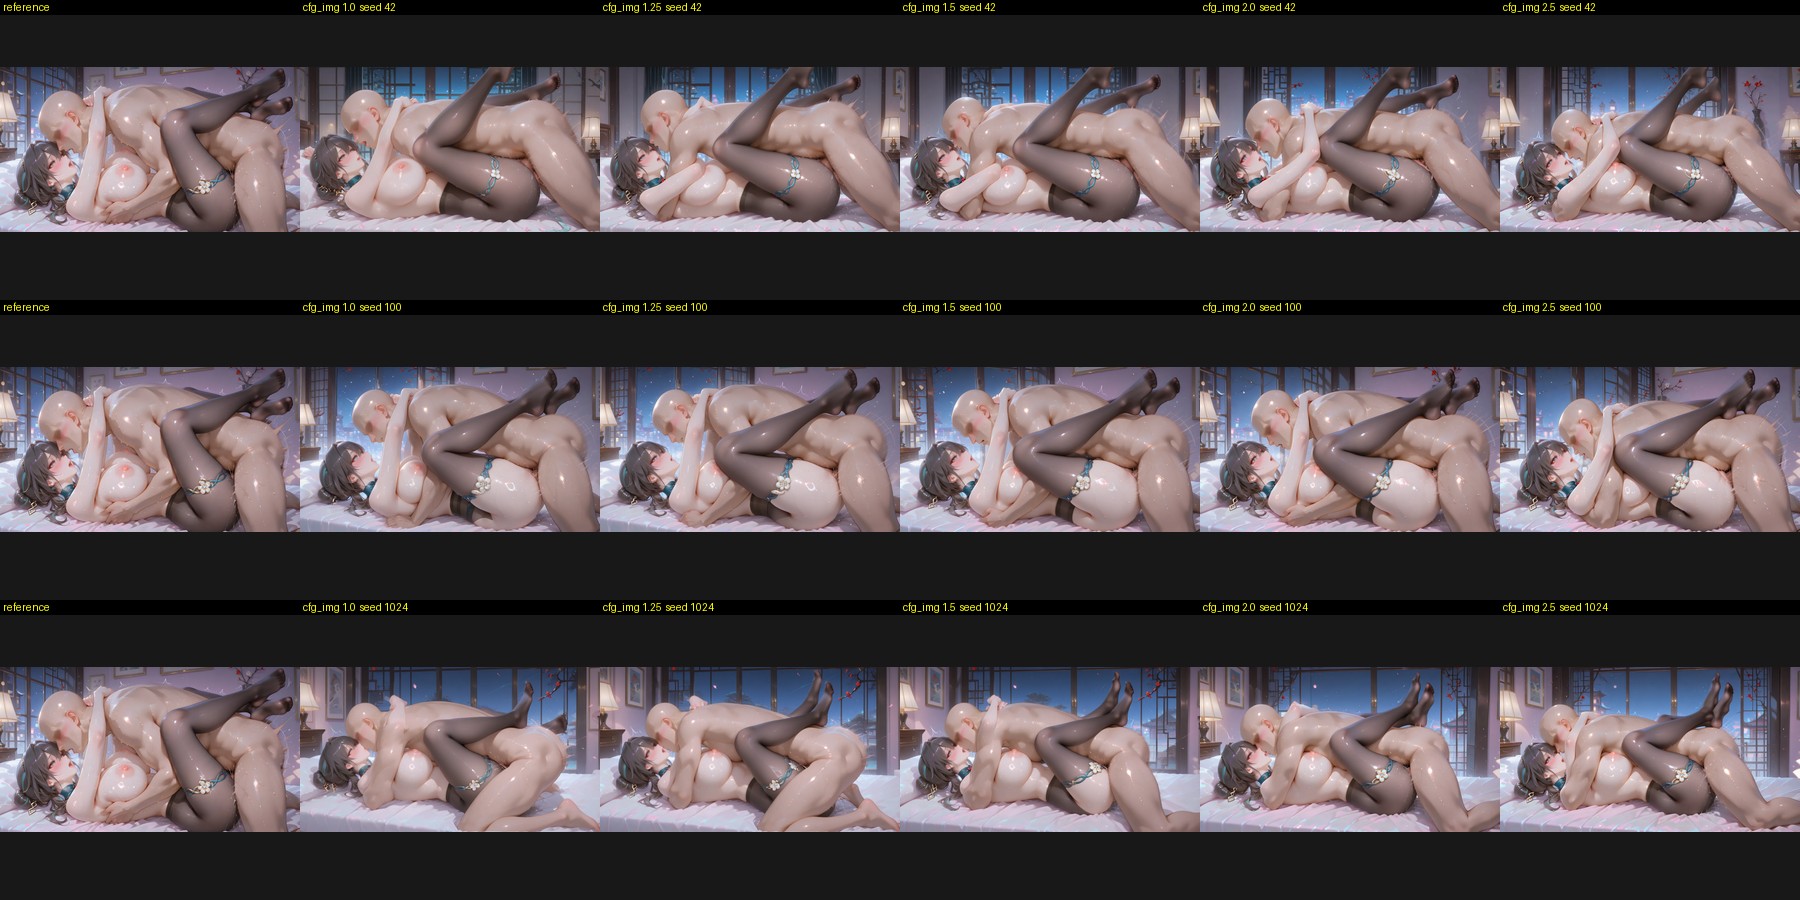
结论:cfg_img 有效、且单调——同种子下,2.5 档相对 1 档的画面改动(256×256 像素 L1)0.104,2.0 档 0.086,1.5 档 0.055。方向是往参考图拉:参考图里的细节被带进输出(xiuren 的红色袜口从 1.25–1.5 档起出现;2ehentai_1126 的背景从暗变成参考图那样的白底、粉色爱心和对话框回来);diff 模式下编辑被削弱(danbooru-diff 在 2.0 / 2.5 档提示词要加的内容变少、参考图原有的马赛克条回来)。到 2.5 档没有崩坏或明显伪影。
副作用:锐度随档位上升(相对 1 档:1.25 档 1.07、1.5 档 1.12、2.0 档 1.30、2.5 档 1.42),对比度略升(0.233 → 0.247),种子间差异下降(0.170 → 0.159 / 0.152,2.0 / 2.5 档约 −6% / −10%),饱和度基本不变(0.255–0.260)。
「离参考图 L1」平均几乎不动(0.181 → 0.184),因为各条方向不同:两条 2ehentai 和 diff 那条更贴近参考图,douyin 那条反而更远(看图是台面、地毯颜色变重,人物和构图不变)。story 模式本来就要改姿势,这个 L1 只能粗看,判断以网格图为准。样本只有 5 条 × 3 种子,没有人物一致性指标。
设置:exports/0028000 的 ema.safetensors(CFG 蒸馏正式版第一次发车会自动选的那一档);推理照 zhuoran 的主线评测(同一份 new_code 快照、InterleaveInferencer、两路真 CFG、41 步 = num_timesteps 42、静态 shift 3、cfg_interval [0, 1]、renorm 关、negative 空);cfg_text 固定 4,cfg_img 1 / 1.25 / 1.5 / 2 / 2.5;heldout15 的 5 条 i2i × 种子 42 / 100 / 1024,输出尺寸 = 各条 GT 尺寸;0–3 号卡,08:38–08:46。指标:离参考图 / 相对 1 档的像素 L1 在 256×256、像素值 0–1 下算;锐度 = 拉普拉斯方差(短边缩到 512)÷ 同条同种子 1 档;饱和度 = HSV 的 S 均值;对比度 = 亮度标准差。脚本、日志、逐张指标在 data/。
| cfg_img | 离参考图 L1 | 相对 1 档的改动 L1 | 锐度 ÷ 1 档 | 对比度 | 饱和度 | 种子间差异 |
|---|---|---|---|---|---|---|
| 1.0 | 0.181 | — | 1.00 | 0.233 | 0.255 | 0.170 |
| 1.25 | 0.181 | 0.033 | 1.07 | 0.237 | 0.258 | 0.169 |
| 1.5 | 0.181 | 0.055 | 1.12 | 0.239 | 0.260 | 0.167 |
| 2.0 | 0.181 | 0.086 | 1.30 | 0.245 | 0.258 | 0.159 |
| 2.5 | 0.184 | 0.104 | 1.42 | 0.247 | 0.256 | 0.152 |
| 条目 | 1.0 | 1.25 | 1.5 | 2.0 | 2.5 | 看图 |
|---|---|---|---|---|---|---|
| 2ehentai_00001062(story) | 0.151 | 0.149 | 0.147 | 0.142 | 0.144 | 构图各档稳,色调略往参考图靠 |
| 2ehentai_00001126(story) | 0.321 | 0.317 | 0.311 | 0.301 | 0.303 | 背景 / 画风往参考图靠(白底、爱心、对话框) |
| danbooru-diff_00000068(diff) | 0.013 | 0.012 | 0.011 | 0.009 | 0.009 | 编辑变弱,参考图的马赛克条回来 |
| douyin_00000351(story) | 0.235 | 0.244 | 0.251 | 0.264 | 0.274 | 人物、构图不变,台面 / 地毯颜色变重 |
| xiuren_00000357(story) | 0.184 | 0.184 | 0.183 | 0.189 | 0.189 | 参考图的红色袜口从 1.25–1.5 档起出现 |
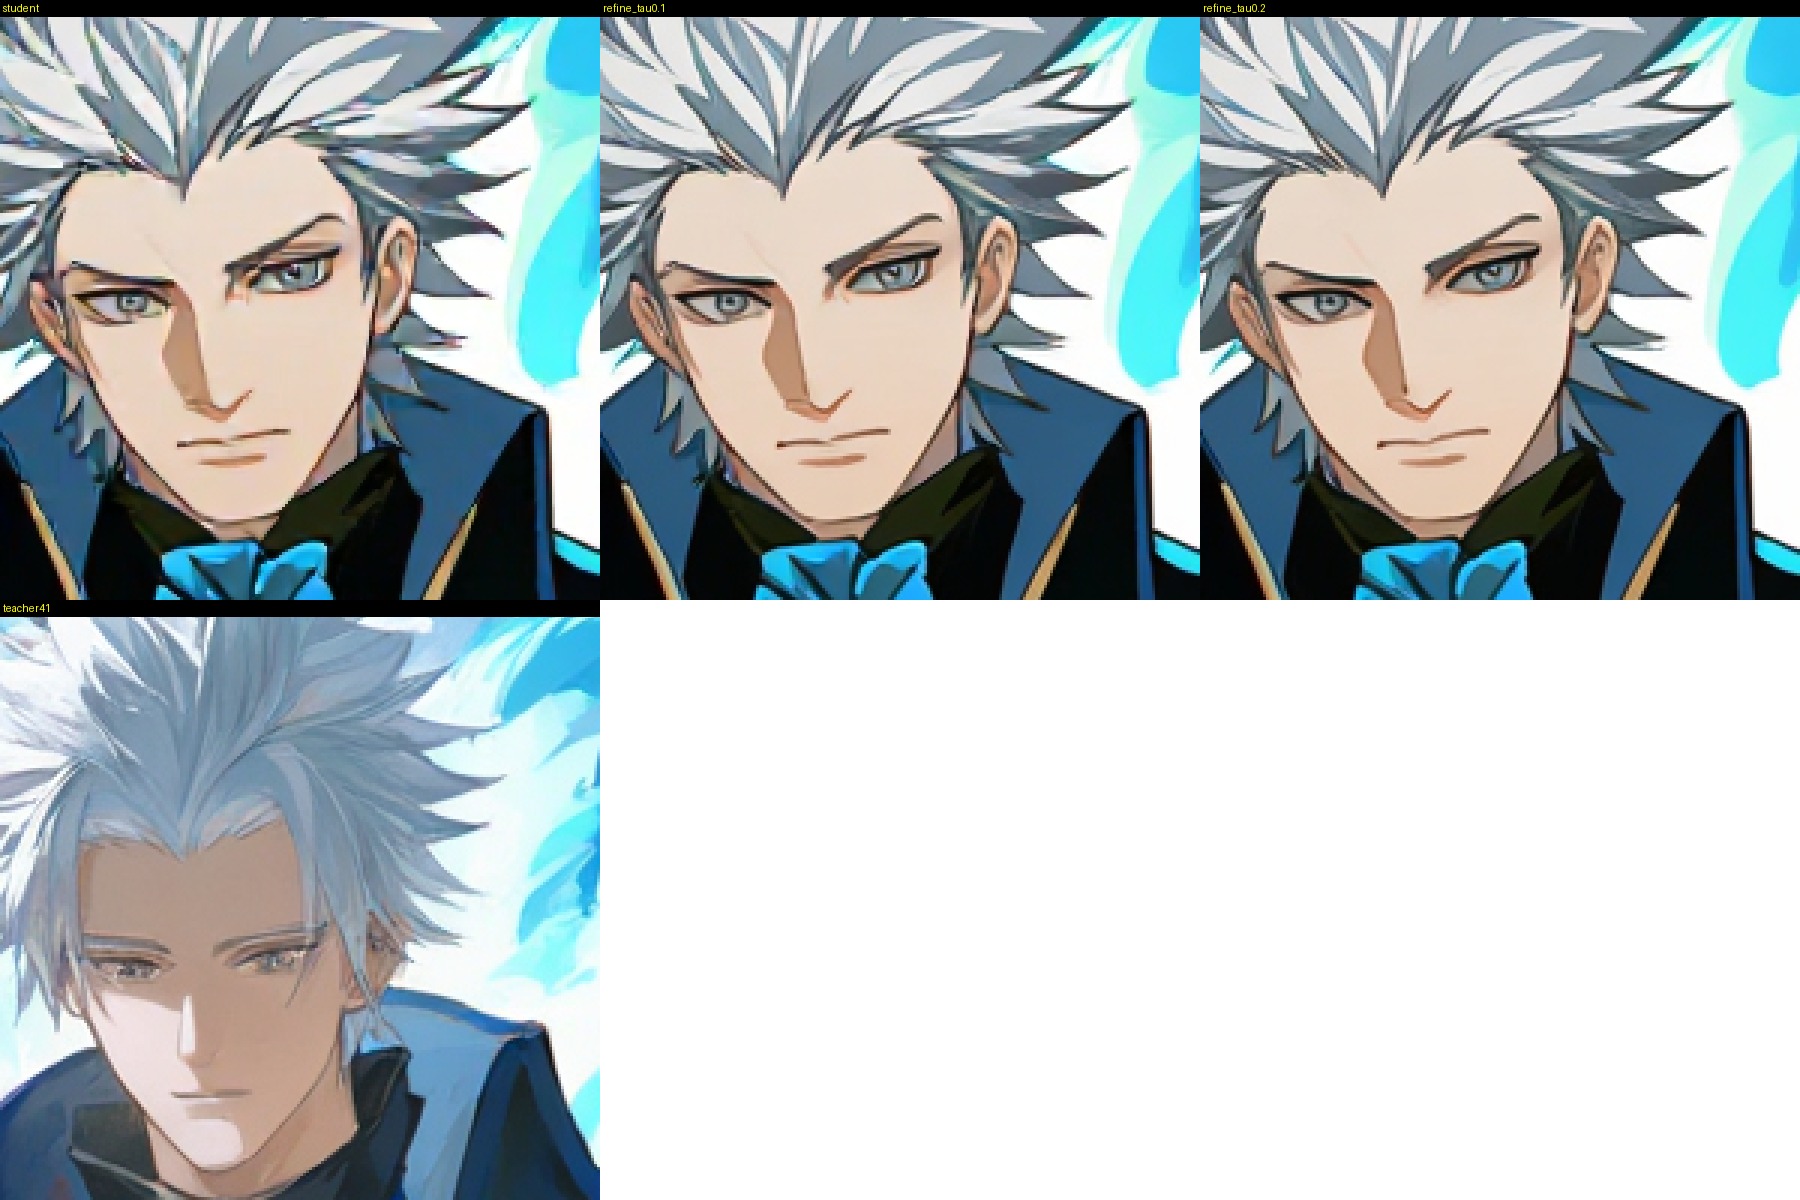
5 NFE:学生 4 步之后加噪再去噪 1 步,锯齿能不能消(10-08) 2026-10-08 01:20 SGT · raw/diag_fivestep_1008/
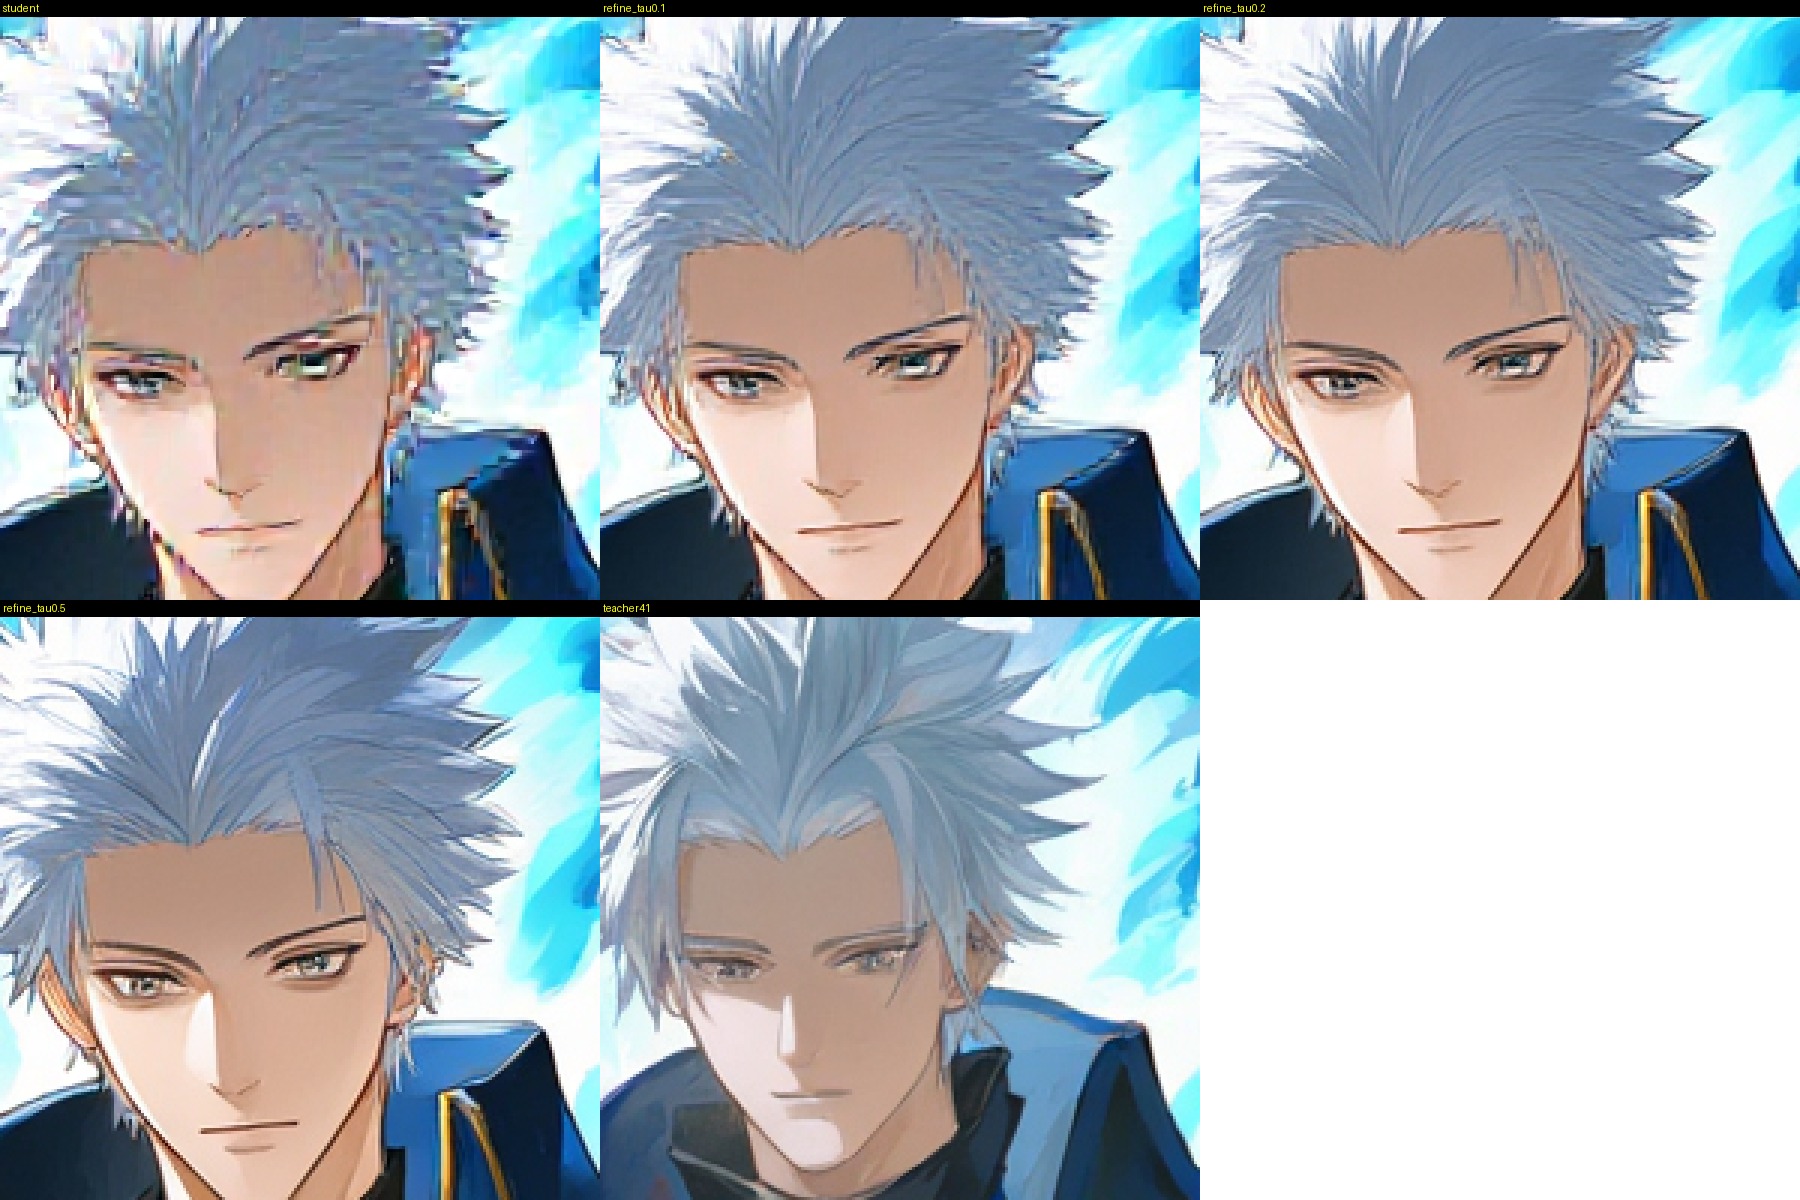
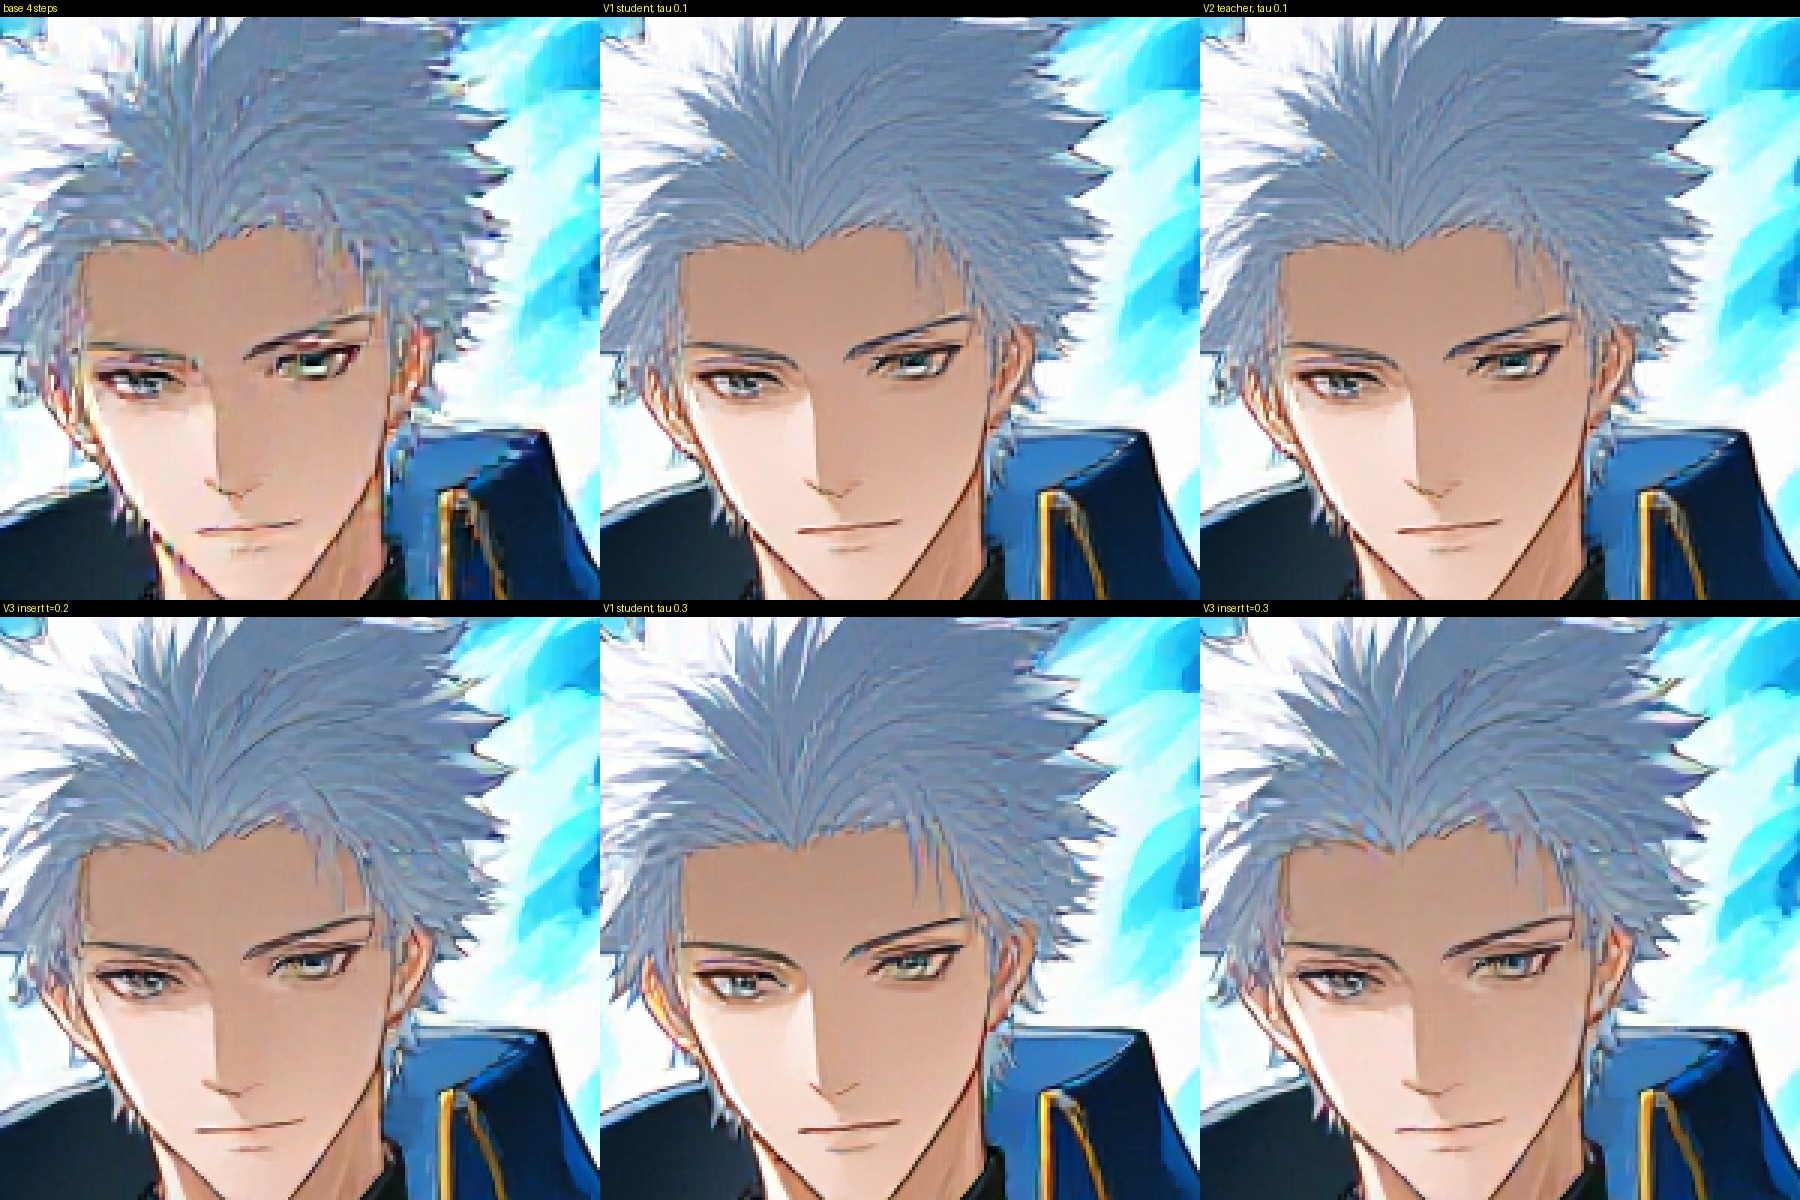
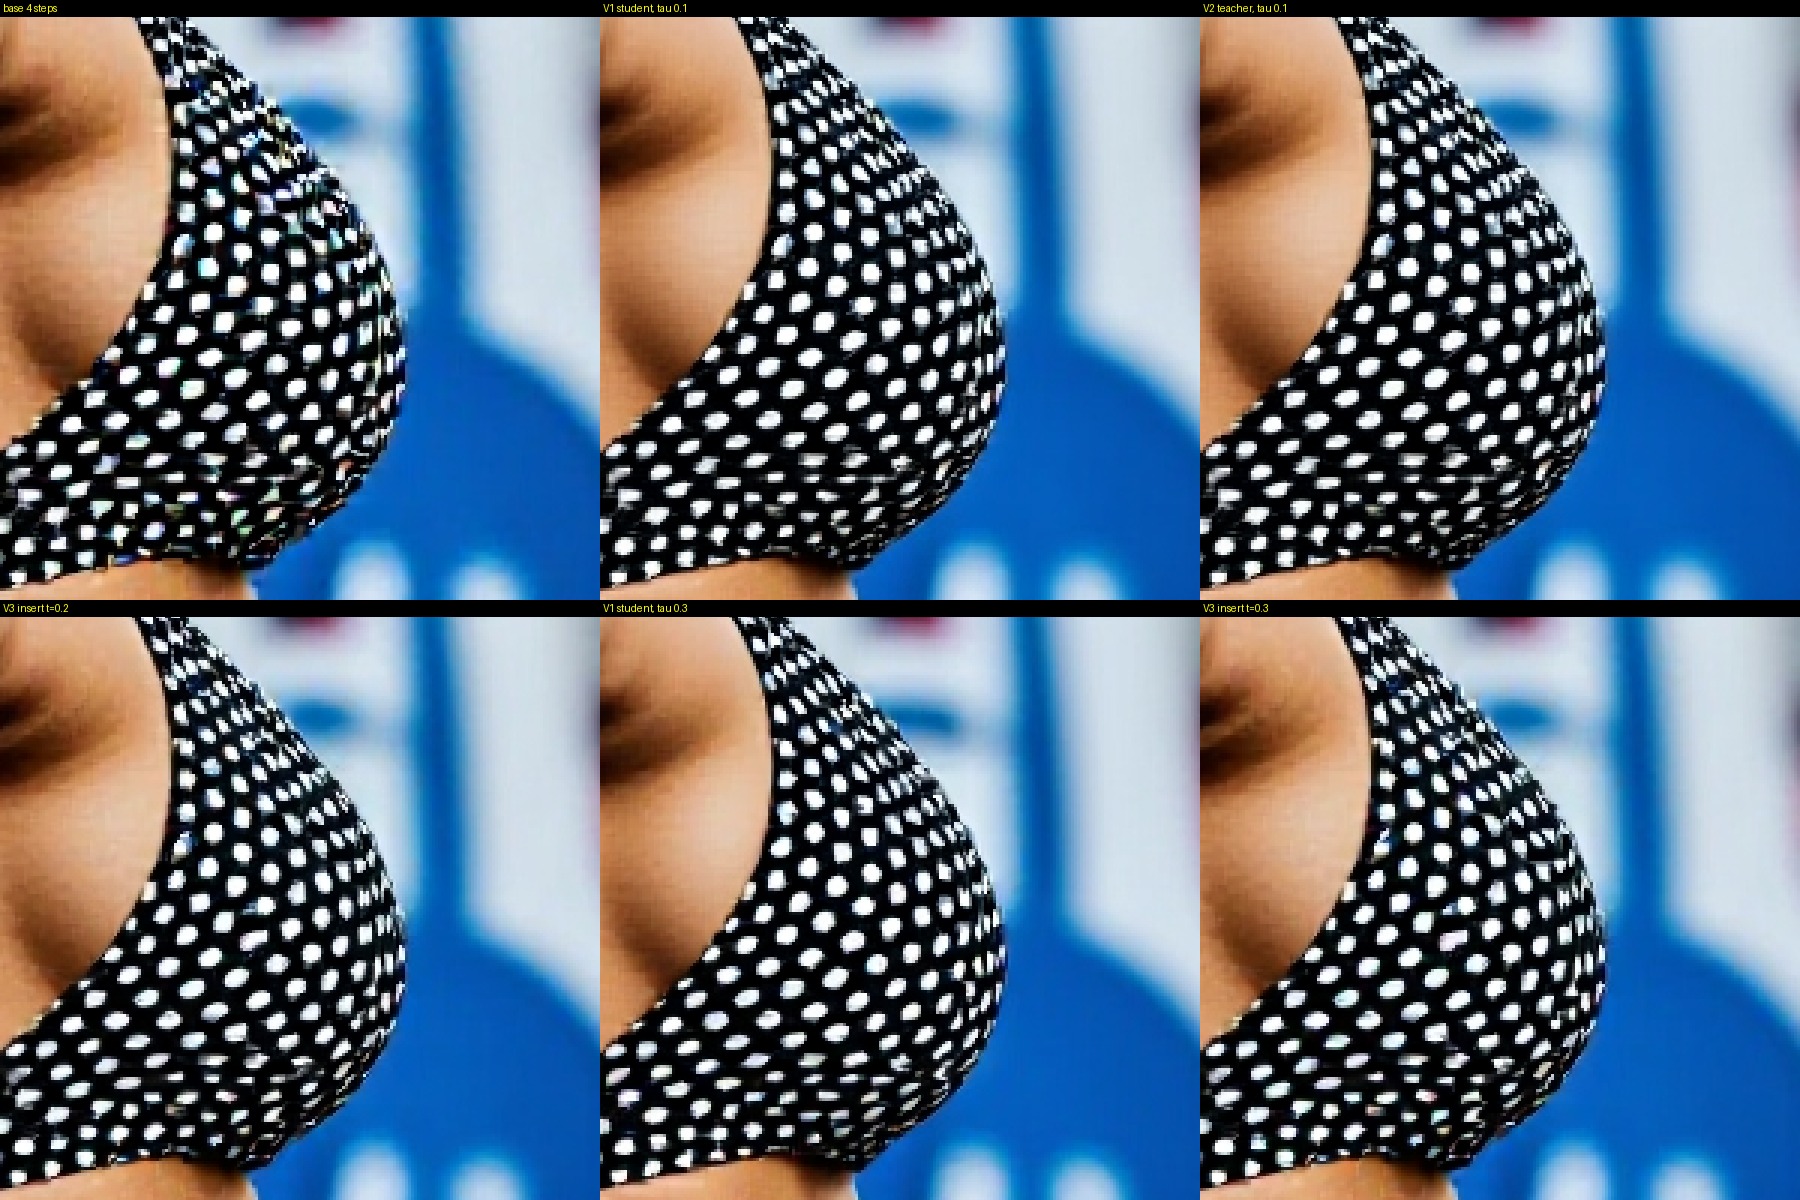
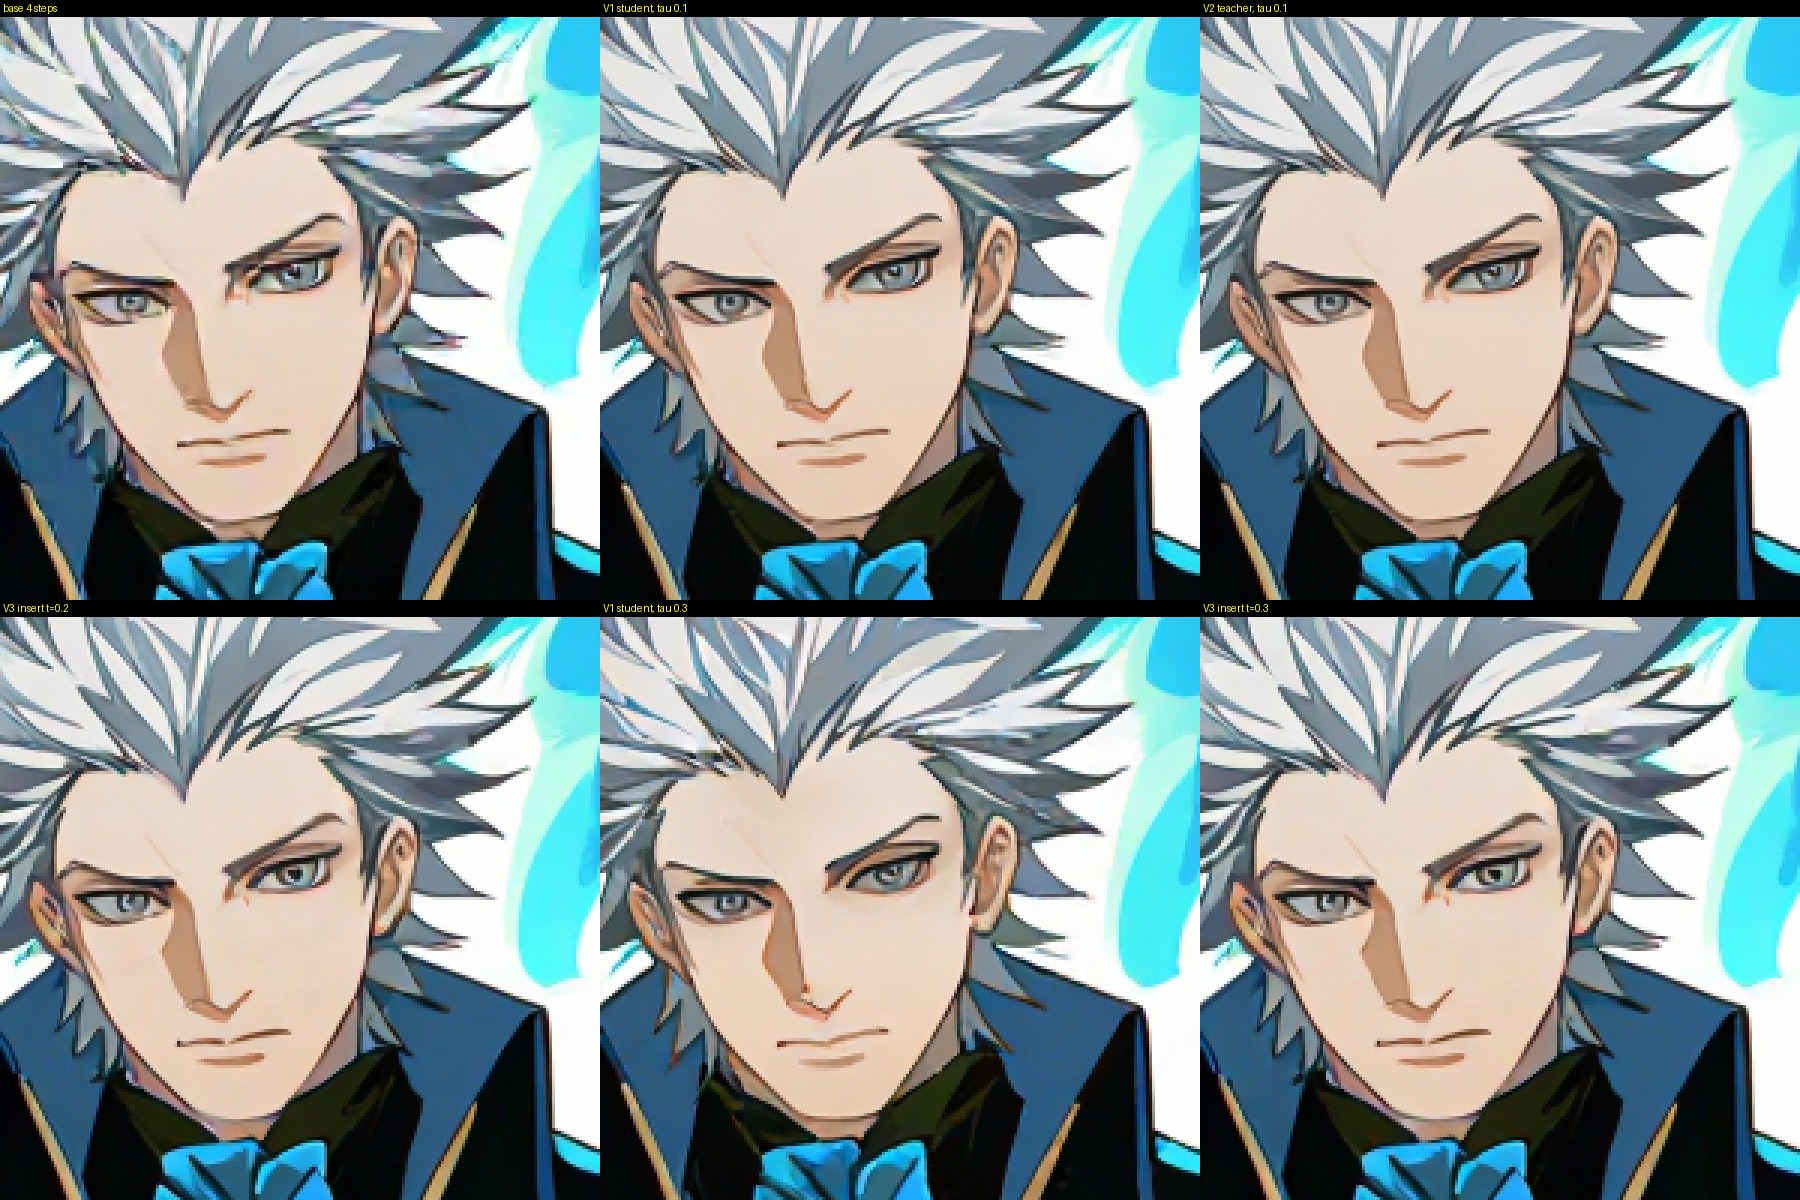
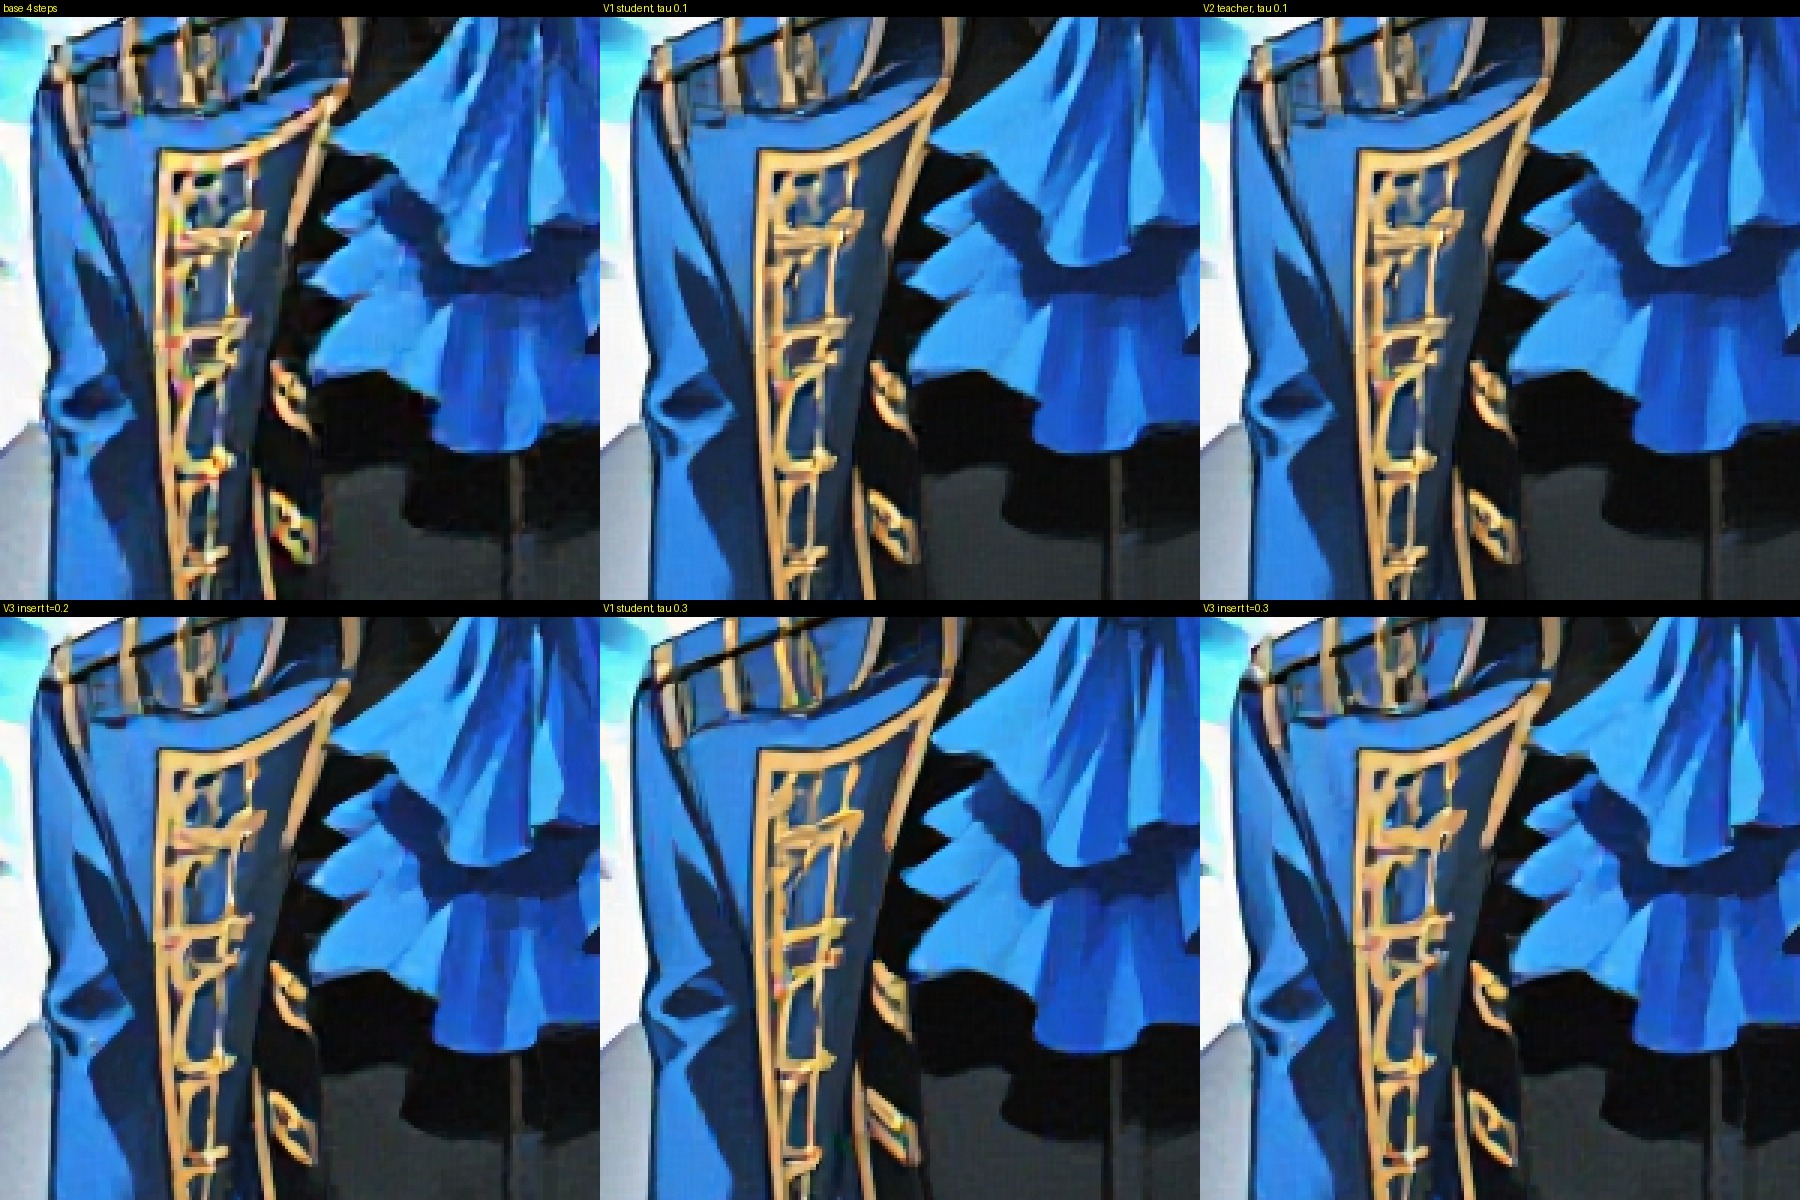
结论:能。学生 4 步出图后,给终图加新噪声到 τ=0.1,再让学生自己前向 1 次取 x̂0(共 5 次前向、不需要教师),锯齿指数 J:B 1.17 → 1.00(到教师水平)、D 1.63 → 1.33、ODE-init→TDM 0.88 → 0.72;锐度只略降(B 1.22 → 1.17、D 1.10 → 1.04、TDM 1.49 → 1.46),放大看边缘仍锐、构图不变,不是靠变糊。
学生这 1 步和教师 1 步(V2,带 CFG 嵌入)效果几乎一样(τ=0.1 时 J:B 1.00 vs 0.99、D 1.33 vs 1.34、TDM 0.72 vs 0.71)——学生本身是合格的低噪去噪器,锯齿来自末步一次从 t=0.625(B / D)或 0.5(TDM)跳到 0,而不是学生缺这个能力。
τ 越大越差:τ=0.3 时 J 回升(B 1.06、D 1.51、TDM 0.80),而且开始改动细节和结构(发丝走向、脸部阴影,TDM 鼻侧出现小红点)。不加新噪声、只在 4 步表末步前插一个时间点(V3,用学生自己预测的噪声)也能降 J(B 1.01–1.03、D ~1.39、TDM 0.76–0.80),但插得越高锐度越高(B 1.23 → 1.34、TDM 1.51 → 1.58),D / TDM 上不如 V1 τ=0.1 干净。
代价:推理从 4 次前向变 5 次(+25%),只用学生权重。没测的:i2i、多样性(V1 在 τ=0.1 加了新噪声)、更小的 τ(0.05)。
设置:heldout15 的 10 条 t2i × 种子 42 / 100 / 1024(30 张),与正式评测同种子同噪声;各组 1000 存档的 student 权重(不是 EMA),训练同款 bf16 推理;V1 / V2 的新噪声对所有方案用同一份(种子 11)。J = 解码图近 Nyquist(0.45–0.5 周期/像素)/ 中频(0.10–0.15)能量比,除以同条同种子教师 41 步(正式评测存图)的 J;锐度 = 拉普拉斯方差(短边缩到 512,与上面指标表同口径)/ 教师,几何平均。因为只有 t2i、bf16、student 权重,base 的锐度和上面指标表的数不完全一样。脚本与原始数据在 data/。
| 模型 | base | V1 τ=0.1 | V1 0.2 | V1 0.3 | V2 τ=0.1 | V2 0.2 | V2 0.3 | V3 t=0.1 | V3 0.2 | V3 0.3 |
|---|---|---|---|---|---|---|---|---|---|---|
| B@1000(旧表,末步从 0.625) | 1.17 | 1.00 | 1.05 | 1.06 | 0.99 | 1.06 | 1.13 | 1.03 | 1.01 | 1.02 |
| D@1000(旧表,末步从 0.625) | 1.63 | 1.33 | 1.48 | 1.51 | 1.34 | 1.51 | 1.60 | 1.40 | 1.40 | 1.38 |
| ODE-init→TDM@1000(shift 3 表,末步从 0.5) | 0.88 | 0.72 | 0.73 | 0.80 | 0.71 | 0.79 | 0.89 | 0.76 | 0.76 | 0.80 |
| 模型 | base | V1 τ=0.1 | V1 0.2 | V1 0.3 | V2 τ=0.1 | V2 0.2 | V2 0.3 | V3 t=0.1 | V3 0.2 | V3 0.3 |
|---|---|---|---|---|---|---|---|---|---|---|
| B@1000 | 1.22 | 1.17 | 1.20 | 1.25 | 1.16 | 1.15 | 1.14 | 1.23 | 1.29 | 1.34 |
| D@1000 | 1.10 | 1.04 | 1.05 | 1.10 | 1.03 | 1.03 | 1.03 | 1.10 | 1.16 | 1.22 |
| ODE-init→TDM@1000 | 1.49 | 1.46 | 1.44 | 1.46 | 1.47 | 1.47 | 1.42 | 1.51 | 1.53 | 1.58 |
学生出图锯齿的来源(B / D / TDM,10-07) 2026-10-07 22:50 SGT · raw/diag_jaggies_1007/
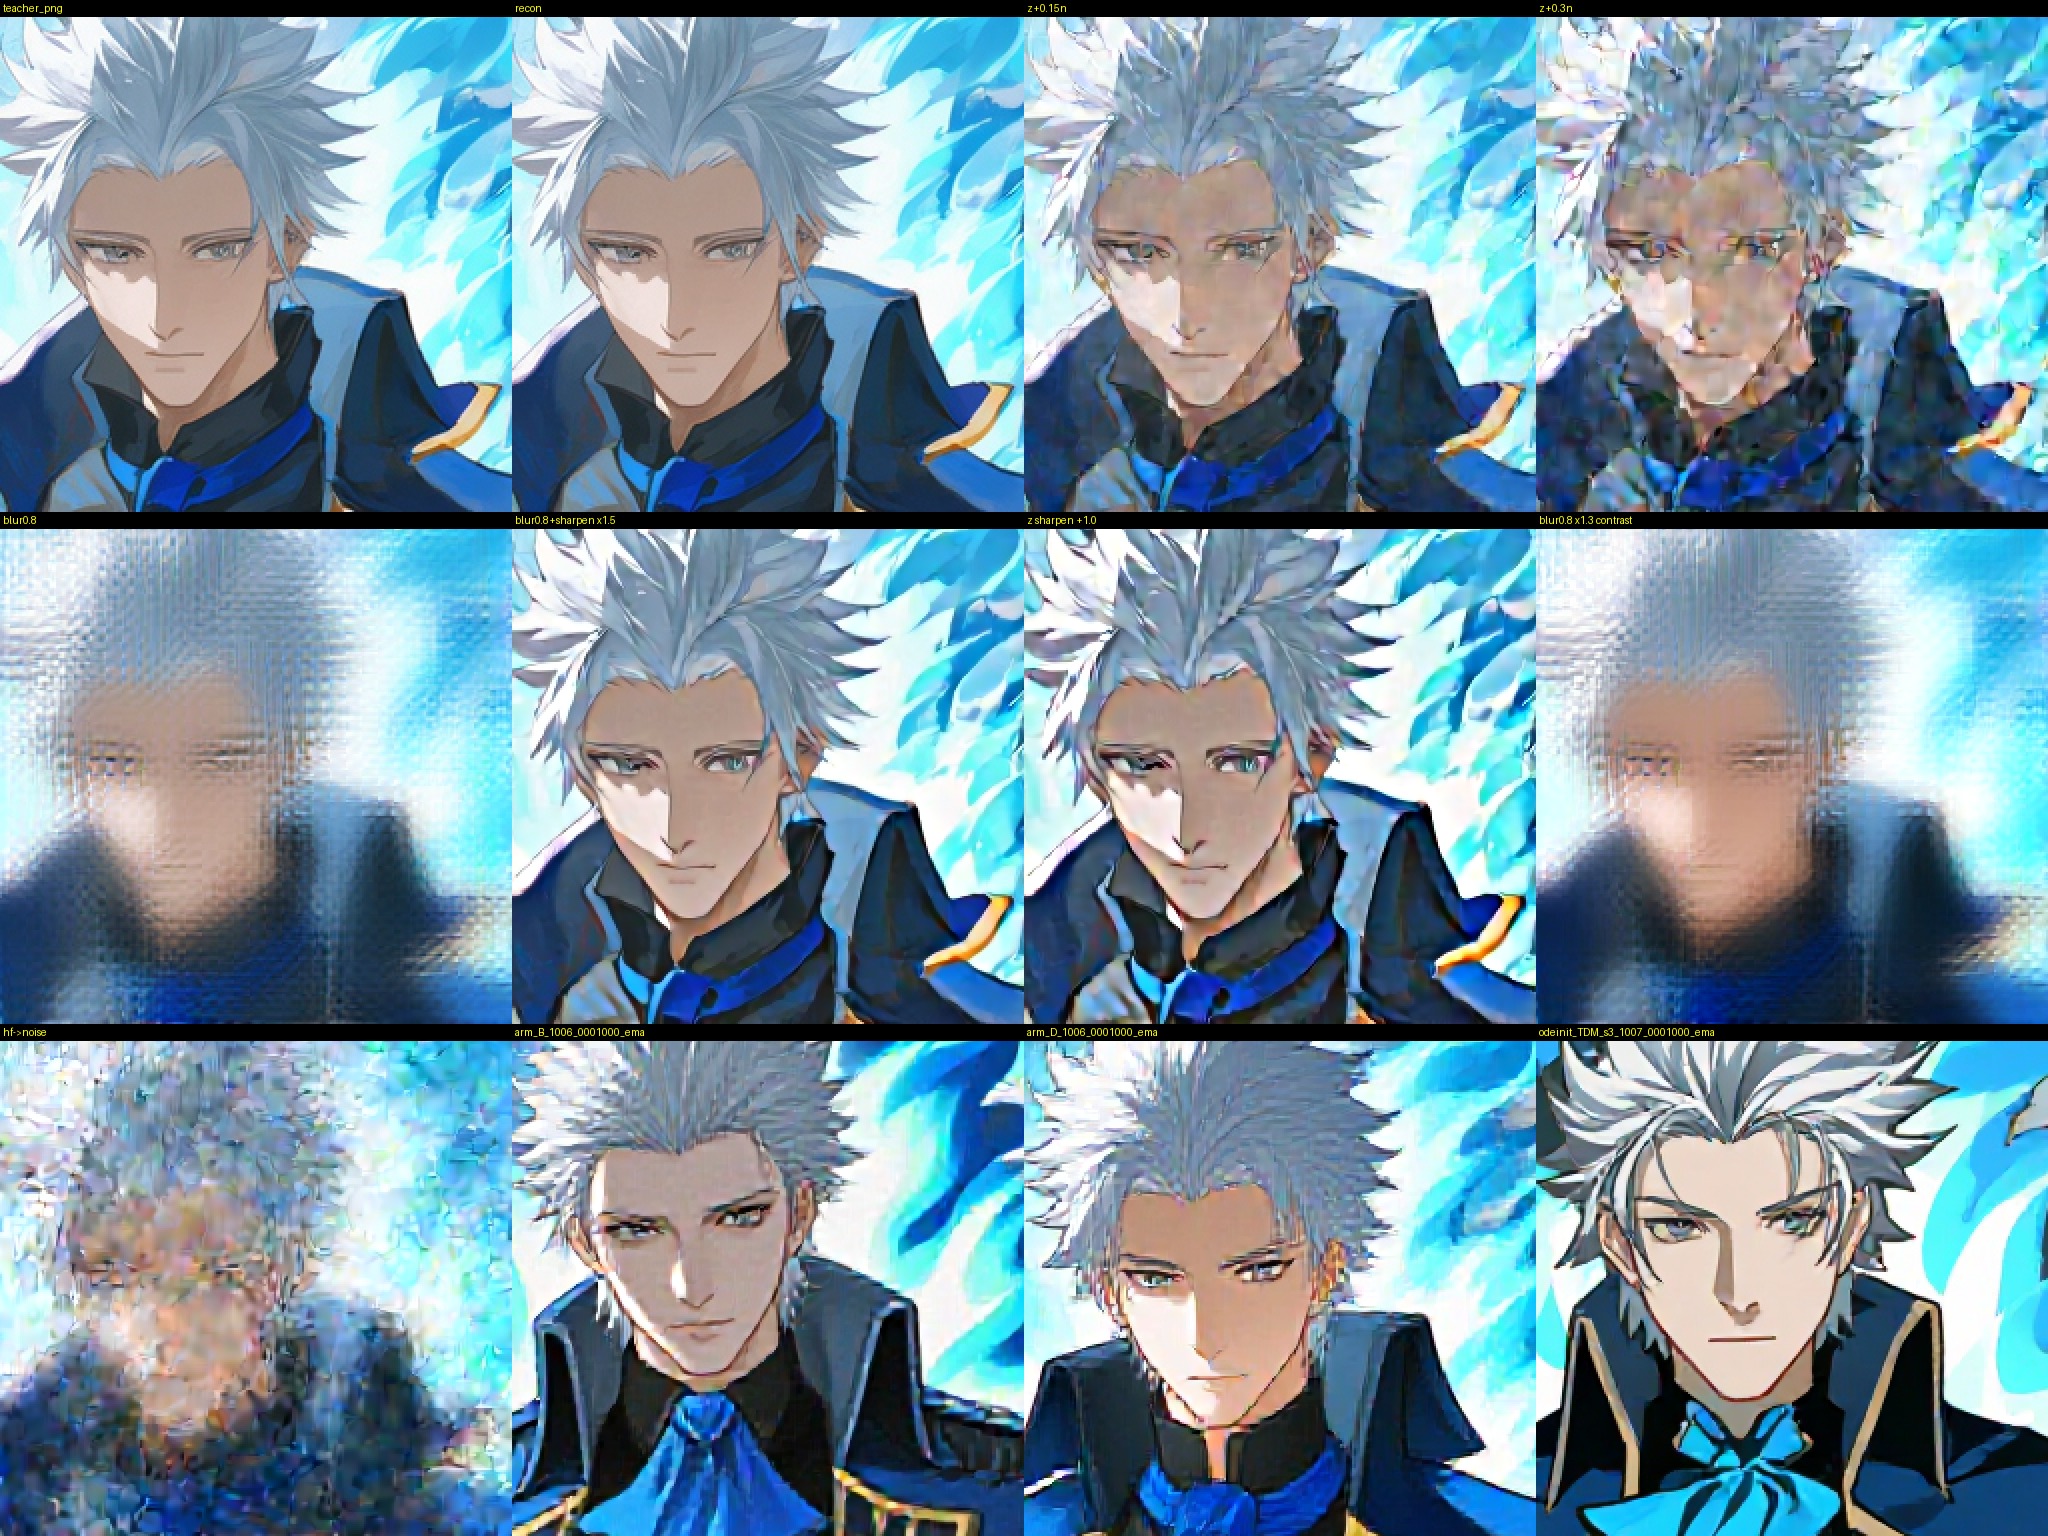
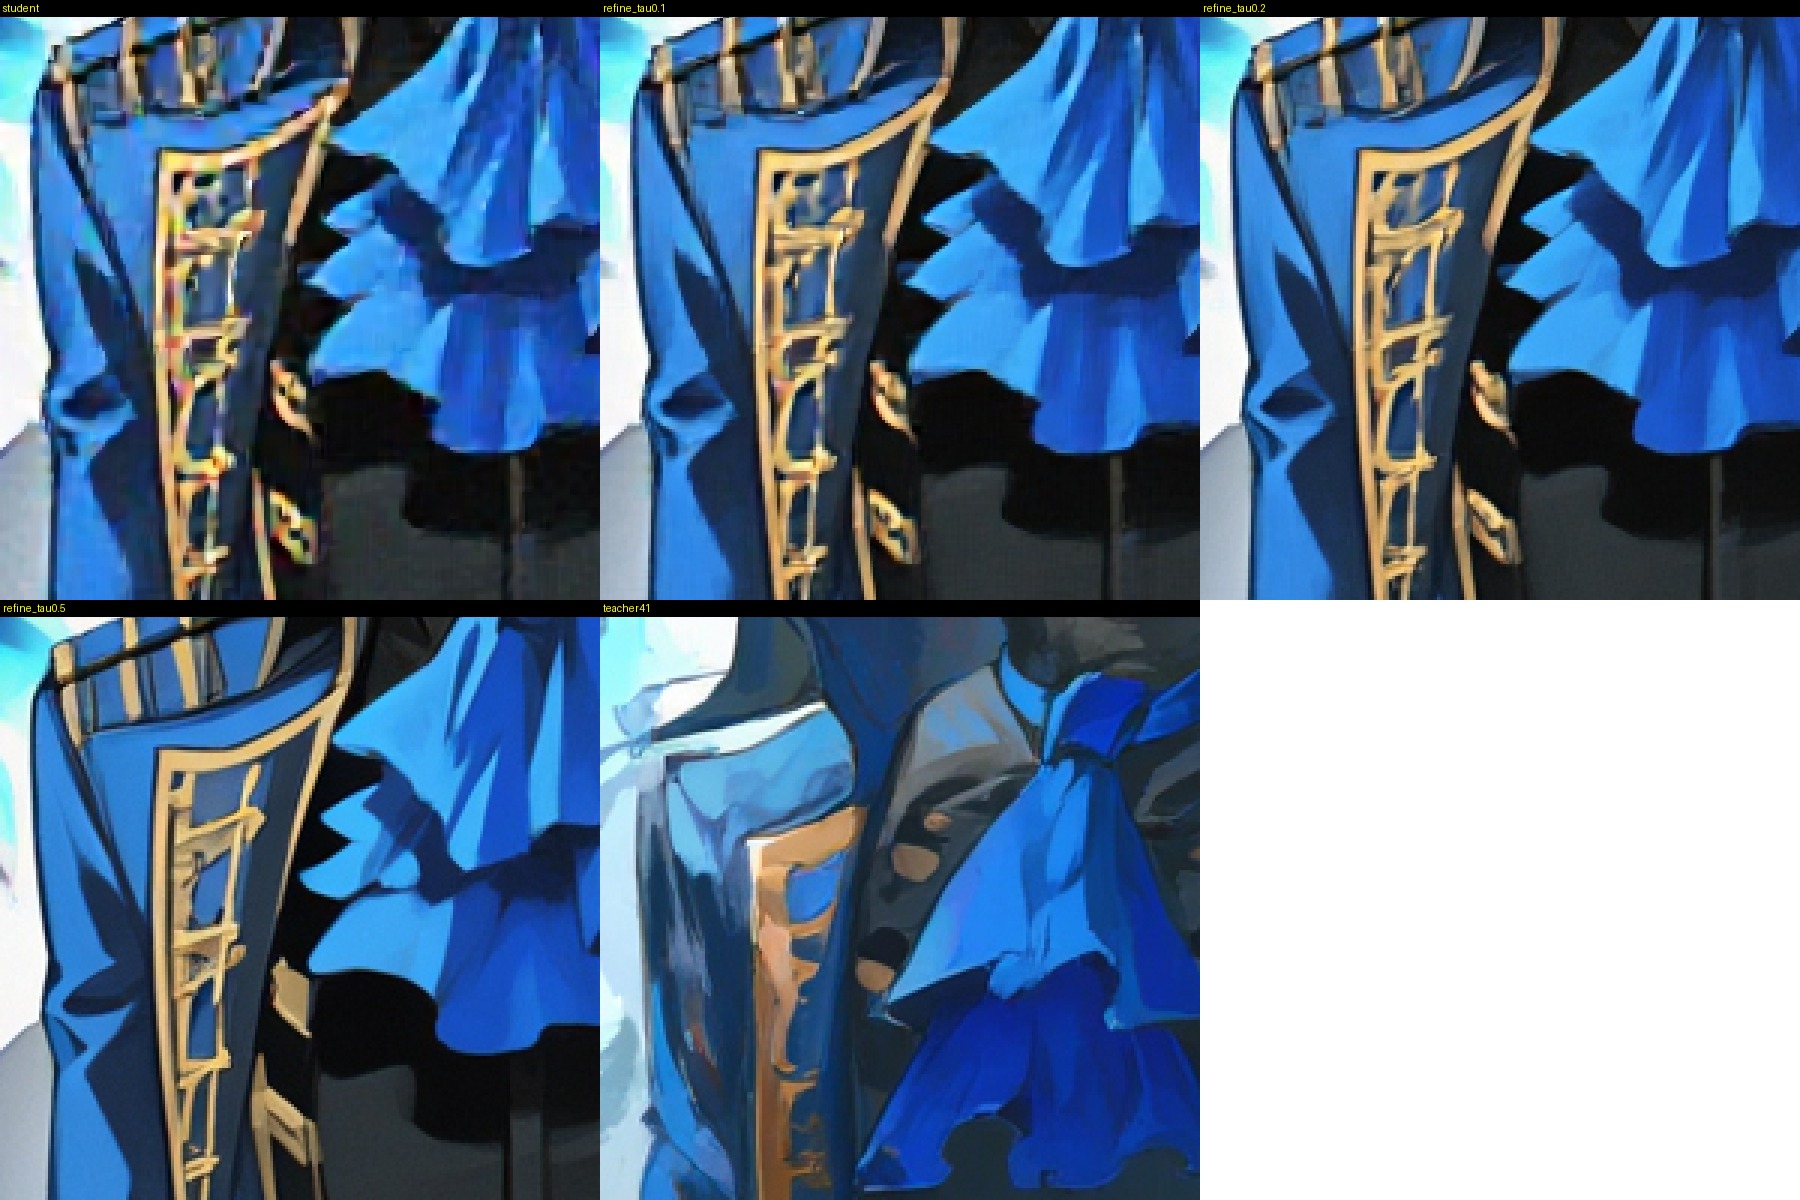
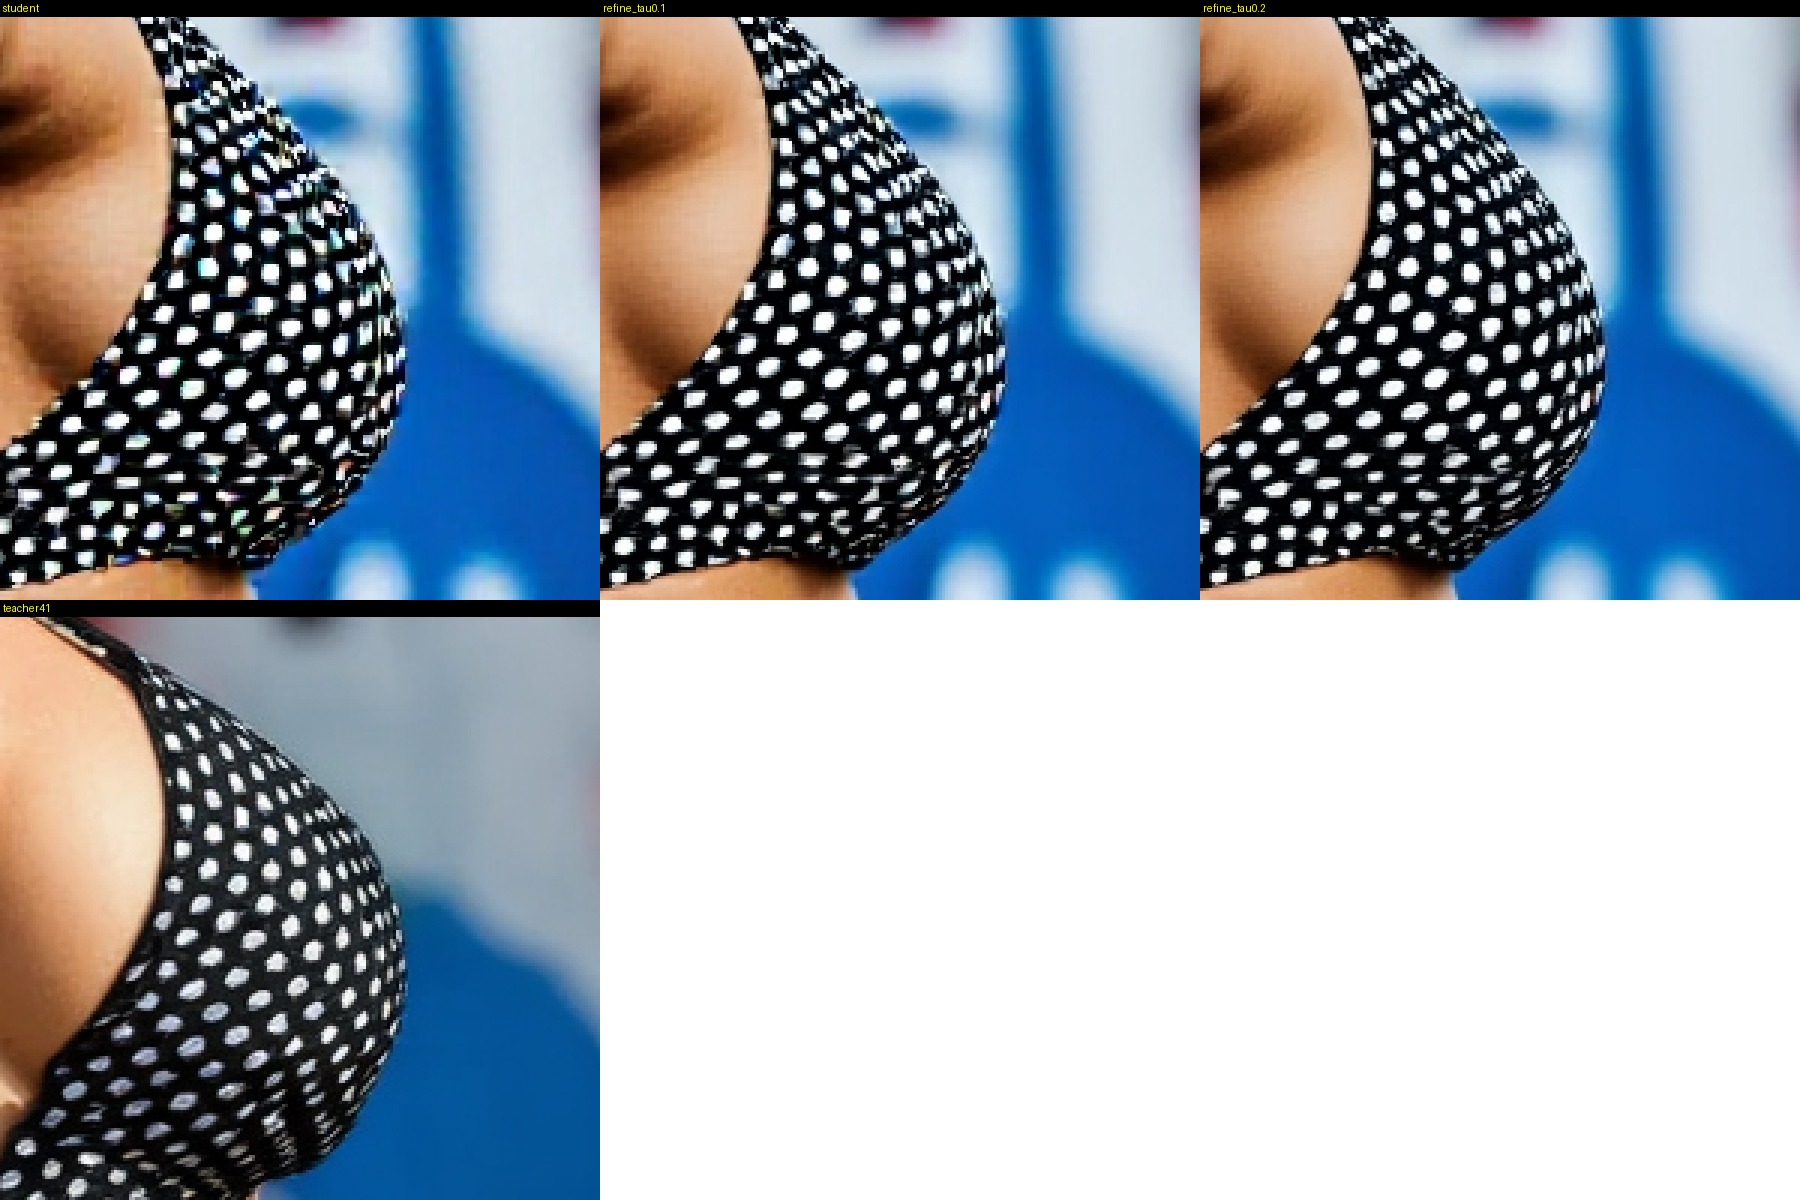
已确认:锯齿(发丝锯齿、皮肤排线、彩色镶边)表现为学生终图 latent 里残留的一层「类白噪声」——在教师终图的 latent 上加白噪声就能复现同样的外观和频谱形状。它在低噪声段(τ ≲ 0.2)能被教师修掉:把学生图加噪到 τ=0.2 再让教师走回 0,B 的锯齿指数降到教师水平,构图不变;D 的从 2.36 降到 1.6 左右后不再下降(看图剩下的是线条本身偏粗硬)。学生末步对输入噪声的透传增益约为教师的 2 倍(B / D / TDM 2.0–2.2 倍,ODE-init 1.5 倍)。核对过的 DMD 公式与梯度路径没有发现算错。
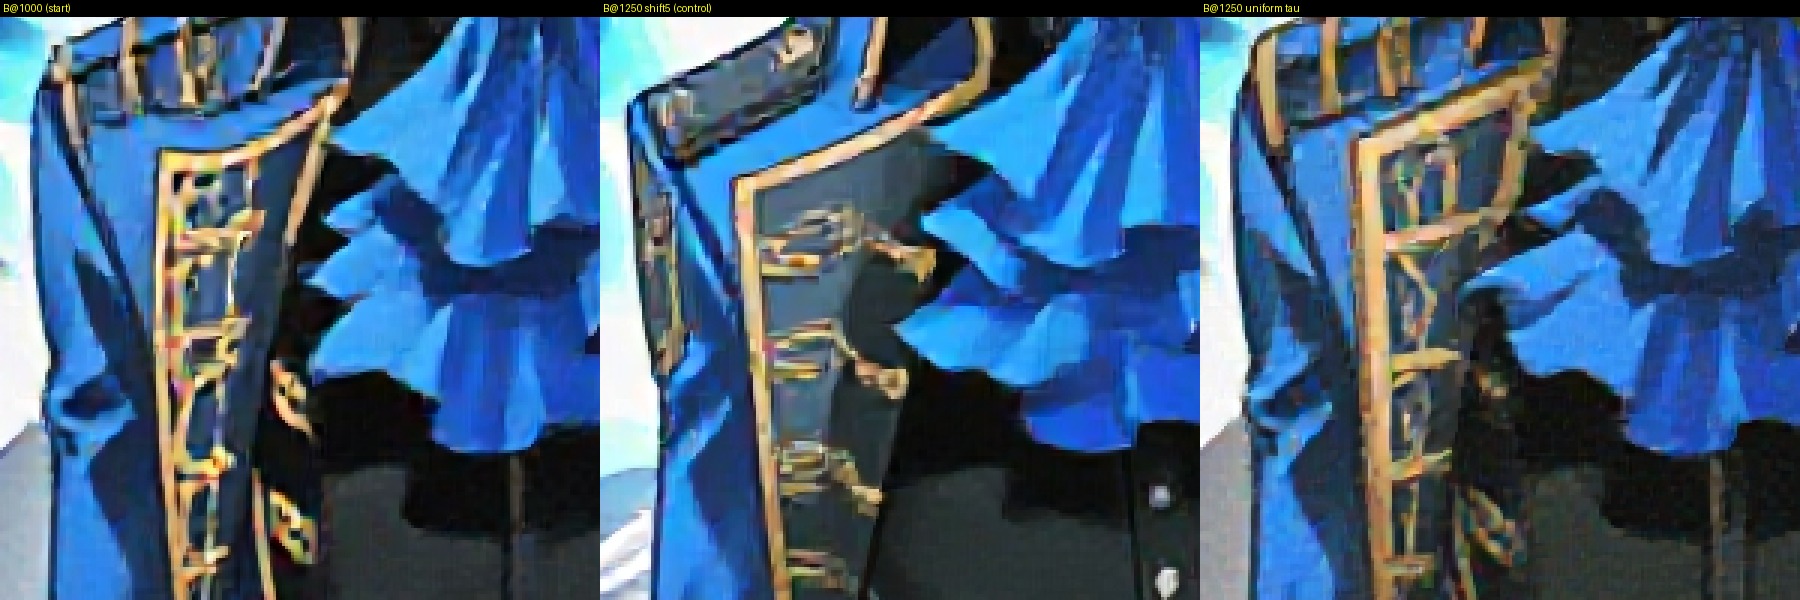
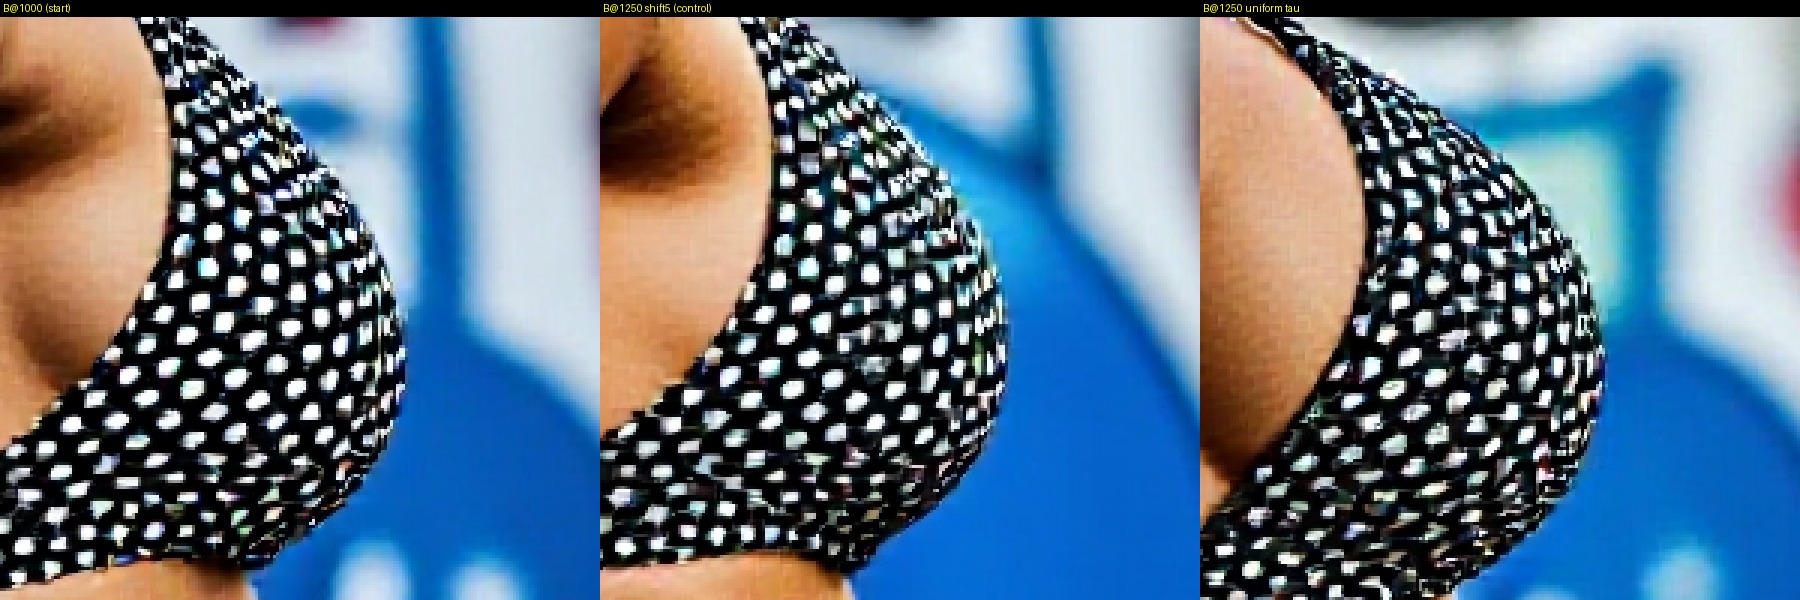
已否定:「训练里 τ 很少落到低段,所以多采低 τ 就能纠正」。因果检验从 B@1000 续训 250 iter、只把 VSD τ 从 shift 5 改成均匀:锯齿指数对照 1.16、均匀 1.58(起点 1.18),锐度对照 1.09、均匀 1.36,肉眼也更糟(见最后两张图)。可能的原因(未分开验证):低 τ 的 DMD 更新只有小部分指向去残留(τ ≤ 0.1 时余弦 0.2–0.3),更新能量约 75% 在高频,且 x0 归一化下低 τ 的更新幅值约为 τ=0.5 时的 2 倍,多采低 τ 等于多灌高频;另外教师 3750 的 CFG 嵌入是在 shift 3 下训的(t<0.2 只占 7.7%),低 τ 时教师的 CFG 推力未必可靠,与锐度上升一致。
锯齿指数 J = 解码图近 Nyquist(0.45–0.5 周期/像素)能量 / 中频(0.10–0.15)能量,除以同条同种子教师 41 步的 J(1 = 教师水平)。旧指标「8 px 网格相位」抓不到这种残留。第 1 张表的 J:8 条 t2i,按诊断进程里用 bf16 现出的教师 41 步归一;第 3 张表的 J:10 条 t2i × 3 种子,按正式评测存的教师图(fp32 建网络 + bf16 autocast)归一——两张表 J 的绝对值不能互比,表内可比。第 3 张表的「锐度」按原分辨率算,和上面指标表(缩到短边 512)口径不同。除复现图(fig1)第 3 行用的是 EMA 的正式评测存图外,诊断里的学生都用 student 权重(不是 EMA),按训练同款 bf16 推理。脚本与原始数据在 probe/、causal/。
| 模型 | 学生 | 教师修 τ=0.05 | τ=0.1 | τ=0.15 | τ=0.2 | τ=0.3 | τ=0.5 | 末步噪声透传增益(学生 / 教师) |
|---|---|---|---|---|---|---|---|---|
| B@1000 | 1.59 | 1.41 | 1.21 | 1.09 | 1.02 | 0.98 | 0.93 | 0.77 / 0.37 |
| D@1000 | 2.36 | 2.09 | 1.79 | 1.64 | 1.62 | 1.62 | 1.59 | 0.70 / 0.34 |
| ODE-init→TDM@1000 | 1.17 | 1.01 | 0.90 | 0.86 | 0.85 | 0.84 | 0.85 | 0.90 / 0.40 |
| ODE-init@500 | 0.98 | 0.89 | 0.78 | 0.71 | 0.68 | 0.64 | 0.60 | 0.72 / 0.49 |
| τ | 0.02 | 0.06 | 0.1 | 0.16 | 0.2 | 0.3 | 0.5 | 0.7 | 0.9 |
|---|---|---|---|---|---|---|---|---|---|
| 余弦(B,x0 归一化) | +0.29 | +0.24 | +0.21 | +0.16 | +0.13 | +0.06 | +0.01 | ≈0 | ≈0 |
| 余弦(D,x_t 归一化) | +0.26 | +0.19 | +0.15 | +0.09 | +0.06 | ≈0 | −0.02 | −0.01 | −0.01 |
| 更新幅值 rms(B) | 0.76 | 0.78 | 0.77 | 0.71 | 0.66 | 0.54 | 0.37 | 0.30 | 0.34 |
| 高频能量占比(B) | 0.76 | 0.76 | 0.75 | 0.75 | 0.75 | 0.73 | 0.65 | 0.51 | 0.20 |
| 模型 | J | J(动漫 / 真人) | 教师从 τ=0.15 修后的 J | 锐度 / 教师(原分辨率) |
|---|---|---|---|---|
| B@1000(起点) | 1.18 | 1.18 / 1.17 | 0.82 | 1.13 |
| B@1250,shift 5(对照 = arm_B_1006 自己续训) | 1.16 | 1.22 / 1.10 | 0.82 | 1.09 |
| B@1250,τ 均匀(diagB_tauU_1007) | 1.58 | 1.62 / 1.54 | 1.11 | 1.36 |